機械翻訳ポストエディット(MTPE)とは?仕組みとより良い実践方法
機械翻訳ポストエディット(MTPE)の実践ガイド。ライトポストエディットとフルポストエディットの違い、機械翻訳(生MT)に人の手が欠かせない理由、品質の測定方法から、従来の「一括生成してから全体を修正する」モデルが抱える課題、そして品質とコストの両面でそれを上回る、翻訳メモリを活用した反復型ワークフローまでを解説します。
目次
私がAIエンジニアになったきっかけの一つは、自分の小説を翻訳しようとしたことでした。そこで出会ったのが、ローカライズ業界の人なら誰もが別の名前で知っているものです。テキストを機械に通し、それを人間が直す、というやり方です。正式には機械翻訳ポストエディット、あるいはMTPEと呼ばれ、2026年現在、プロの翻訳で主流となっている手法です。
理屈としては合理的にも思えます。しかし、高性能なLLMが使える今、その一般的な「進め方」は時代遅れになりつつあります。まず機械ですべて翻訳し、後から人間が全体を修正するという手法は、人の時間と計算リソースを使う順番を誤っています。
その裏には、より低コストで優れたワークフローが隠れています。
本ガイドでは、その両方を取り上げます。前半では、MTPEの基本とその仕組みについて率直にお伝えします。受託案件の獲得やB2B SaaSの営業にあたっては、ISOで標準化された従来の手法を理解しておく必要があるためです。後半では、標準的な一括処理モデルがどこでつまずくのか、そして人間をもっと早い段階で関わらせてどう改善するのかを解説します。
機械翻訳ポストエディット(MTPE)とは?
MTPEは、PEMT(post-edited machine translation)とも呼ばれ、次の3段階で進められます。
- 機械翻訳(MT):機械翻訳エンジンや大規模言語モデル(LLM)が、原文から初稿となる訳文を生成します。この下書きは生MT(raw MT)と呼ばれます。
- ポストエディット(PE):人間の言語の専門家が原文と生MTを照らし合わせて確認し、誤訳の修正、用語の適用、トーンの調整を行いながら、目標とする品質基準まで仕上げます。
- 品質管理(QA):表記や用語の統一性、フォーマット、最初の編集で見落としがちなエラーがないかを最終確認します。
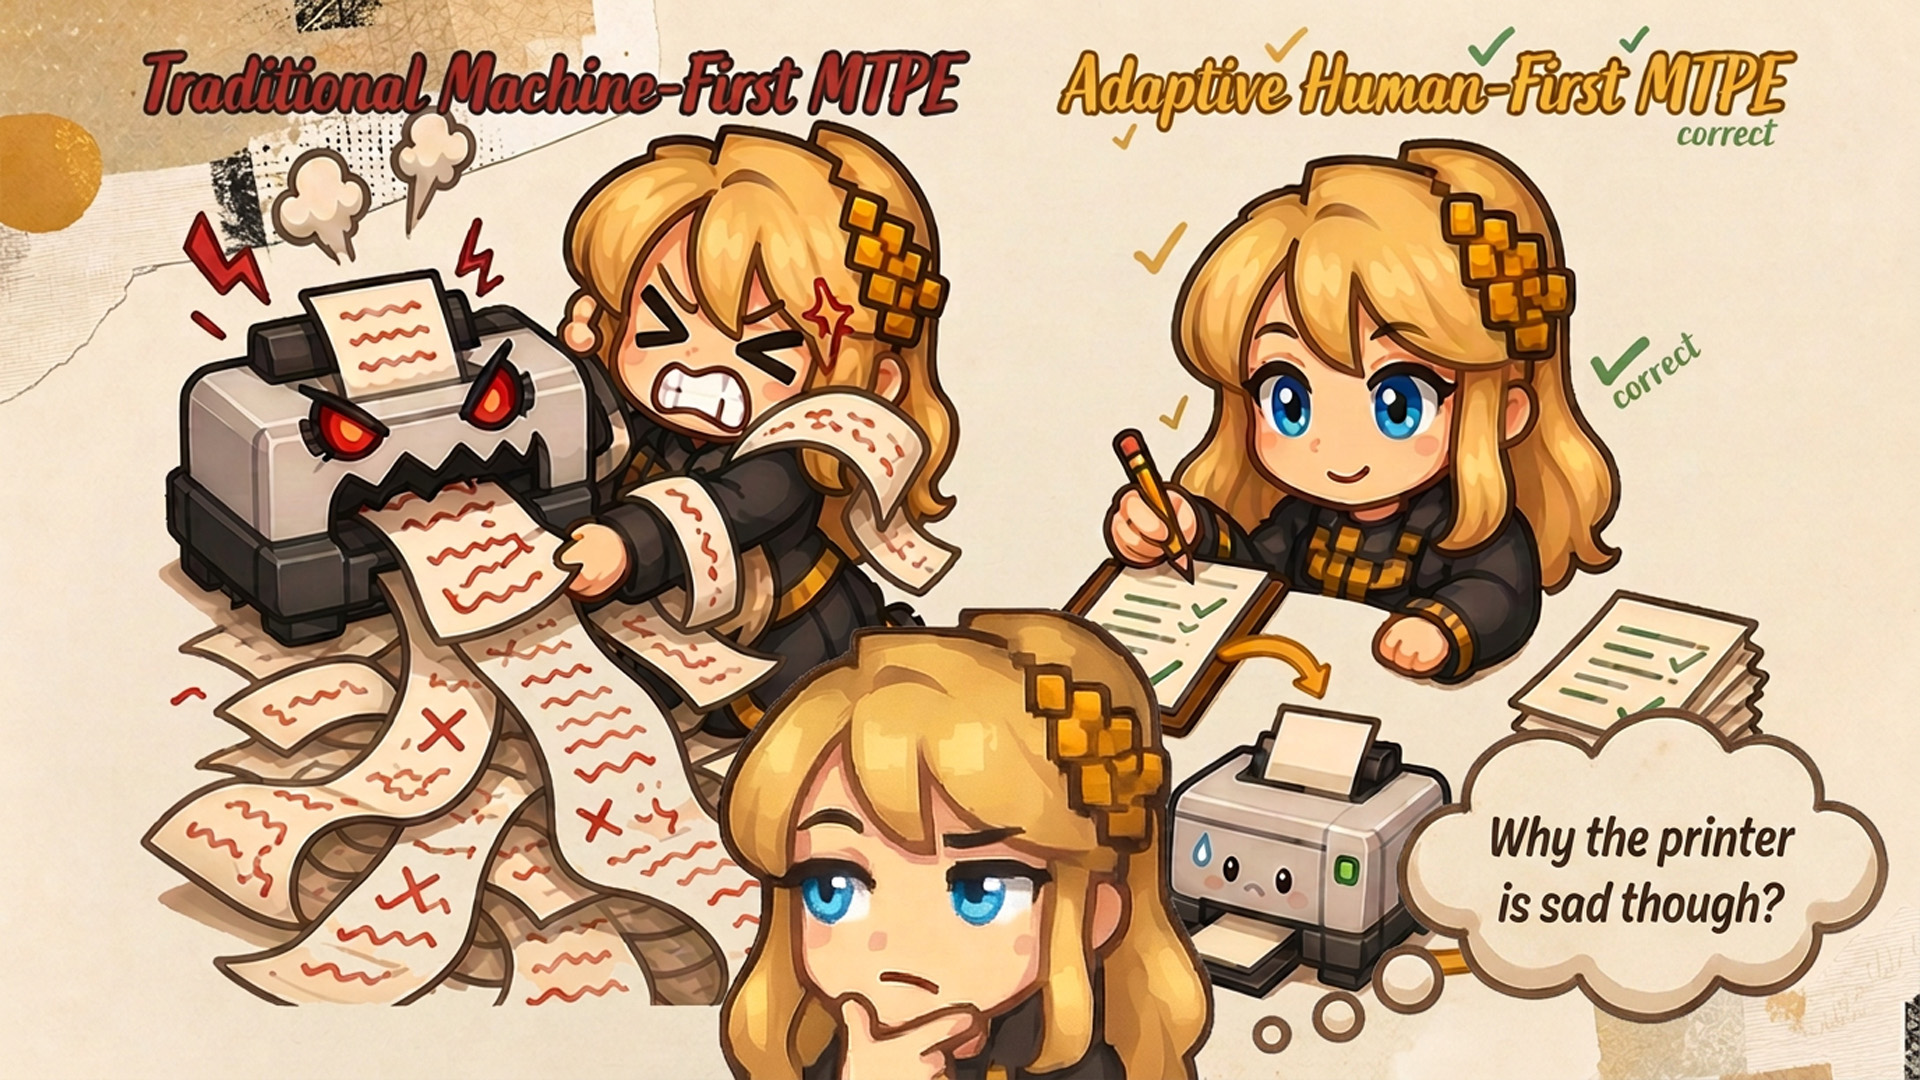
一般的な運用では、これは一括で引き渡す形をとります。まず機械がドキュメント全体を翻訳し、その後に人間がドキュメント全体を編集します。この進め方を覚えておいてください。後ほど詳しく反論するポイントです。
「すべて人間が翻訳する」でも「機械に丸投げする」でもなく、なぜMTPEが存在するのか。それは、多くのコンテンツにとって、どちらの極端なアプローチも適切ではないからです。
人間が一から翻訳する場合、規模が大きくなると時間もコストもかかります。一方、生MTは高速かつ安価ですが、実用に耐えうる品質のMTが登場してからはまだ10年も経っていません(機械翻訳「そのもの」には数十年の歴史がありますが)。そして、どれほど優れたLLMやワークフローを使っても、その出力を鵜呑みにするリスクは高すぎますし、「美しく」翻訳する力は人間のほうがはるかに上です。
したがって、MTPEは現実的な妥協点といえます。機械的な70%の作業は機械に任せ、訳文の信頼性を左右する残りの30%に人間の集中力を注ぎます。
(少なくとも、翻訳会社やクライアント企業はそうあることを望んでいます。しかし実際の現場では、人間がより深く介入して品質を高めても報酬は増えないか、あるいはまったく介入せずにおざなりな結果に終わるかのどちらかになりがちです。)
いずれにせよ、2020年代の翻訳業界において、何らかの形でのMTPEが標準(デフォルト)となっています。
ライトポストエディットとフルポストエディット:2つのレベル
要約すると、この区分は現実には厳密に存在するわけではありませんが、業界の共通認識として知っておく必要があります。
「ポストエディット」と一口に言っても内容は様々です。MTPEプロジェクトで最も重要な判断は、どのレベルを目指して編集するかを決めることです。これによって、各セグメントにかける時間や、どこまで手を加えずに残してよいかが決まります。
よくある失敗は、ライトエディットで十分な優先度の低いコンテンツを含め、すべてを習慣で最高品質まで編集してしまい、MTPEによって得られるはずだった時間短縮のメリットを台無しにしてしまうことです。これは翻訳者だけの問題ではなく、ライトポストエディットに対して過剰な期待を設定してしまう編集者やマネージャー側の問題でもあります。
その逆のミスはさらに深刻です。ランディングページをライトエディットで済ませて「一見それらしい」程度の訳文を公開し、信頼を損ねてしまうことです。Claude Codeによる翻訳の大半が、まさにこれです。完全な機械翻訳やライトMTPEでローカライズした結果、アプリのコンバージョン率が「下がった」という報告もあります。
実際には境界線は曖昧で、現実のMTPEはその中間のどこかにあります。プラットフォームや翻訳会社によって、作業の度合いは恣意的に、あるいはプロジェクトごとに決められます。社内独自のパイプラインや慣習も多く、QAレポートや承認フローがつきものです。
このように定義が曖昧だからこそ、多くの翻訳者がMTPE案件を敬遠します。良い仕事を成し遂げたという手応えは得にくく、かといって丁寧に仕上げても報酬面で報われるわけではありません。
生の機械翻訳に今なお人間の手が必要な理由
2026年の今、当然こんな反論があるでしょう。「最新のLLMは流暢なのだから、もう生MTのままで十分なのではないか?」
しかし、その流暢さこそが罠なのです。従来の機械翻訳は破綻が目に見えていたため、未編集のまま信用する人はいませんでした。一方、最新のモデルは読むぶんには非常に美しい文章を生成するため、読者やレビュアーに誤った安心感を与えてしまいます。
さらに厄介なのは、意味は通っていても「いかにもAIが書いたような」トーンが漂う文章が生成されることです。これによってブランド全体の印象が安っぽくなってしまいます。この問題自体は簡単に解決できるにもかかわらず、まさにこの罠にはまる人が後を絶ちません。
Claudeには、次の点もぜひ入れるべきだと強く勧められました。
- ブランドイメージの毀損:機械翻訳エンジンには、言語の専門家のような文化的ニュアンスへの理解はなく、特定の市場において何が適切で何が無作法かという感覚もありません。原文ではニュートラルな表現であっても、訳文では不器用、横柄、失礼、あるいは単に「奇妙」な印象を与えてしまうことがあります。読者が離れていく原因となるのは、まさにこうした「AI特有の不自然さ」です。
- 顧客への誤った情報の伝達。最も高度に訓練されたモデルであっても、原文にある節を勝手に省いたり、原文にない単語を付け足したりすることがあります。流暢で確信に満ちた文章の中に紛れ込んだ訳抜けや事実関係のズレは見つけ出すのが極めて難しく、法務、医療、財務などのコンテンツでは深刻な被害を招きかねません。これも技術的には解決できる問題ですが(まさにこうした訳抜けを検知するためにSmart Proofreadがあります)、それでも現場では日常的に起きています。
- ブランドイメージの希薄化。生のLLMの出力が、ブランド独自のトーンや用語を反映することは滅多にありません。サイト全体で製品名や決まり文句の訳語が微妙に揺れてしまうと認知されにくくなり、ブランドの印象は少しずつぼやけていきます。スタイルガイドや用語集を活用すれば解決できますが、旧来の機械翻訳パイプラインでは十分に対応しきれないのが実情です。
したがって、顧客のコンバージョン獲得や法的拘束力など、テキストに確かな成果が求められる場面では、人間の関与は不可欠です。しかし、従来の標準的なワークフローがうまく答えを出せていない真の課題は、人間が「いつ」介入すべきかという点にあります。
MTPEを難しくしている本当の理由:4つのボトルネック
実際のところ、ポストエディターが最も頭を抱えるのは、引用符や日付の形式といった問題ではありません。そうしたものはQAルールの領域です。本当に難しいのは、一見流暢に見える出力の妥当性を評価し、セグメントにどの程度の手を加えるべきかを判断することです。しかも、あらゆる機械翻訳の下書きが一律に同じ時間短縮をもたらすという前提に基づいたビジネスモデルのもとで、その判断を下さなければなりません。
ポストエディットの作業負荷に関する研究では、作業を「認知的負荷」「技術的負荷」「時間的負荷」の3つに分類しています。これらの要素は必ずしも綺麗に連動するわけではありません。キー入力自体は2文字で済むものの事実確認に何分もかかる文もあれば、解決策は明白なのに全文を書き直さなければならない文もあります。
現場で繰り返し直面するボトルネックは、主に次の点です。
- 一見正しく見えても、直すには文脈が必要な誤りの検知。最新の機械翻訳は、節を省いたり、意味を改変したり、もっともらしいが不適切な用語を選んだりしながらも、洗練された訳文を出力できてしまいます。文章が流暢であるために警戒のサインが見えにくくなり、エディターは原文、ドキュメントの文脈、そして現実の事実関係を絶えず照合しなければならなくなります。これらすべてに時間と労力がかかります。誤訳、整合性の破綻、構造上の誤りは、ポストエディットの作業負荷を増大させる最も大きな要因の一つであることが、数々の研究で一貫して指摘されています。
- 承認、修正、再翻訳の判断。セグメントごとにトリアージが求められます。そのまま残すか、最小限の修正にとどめるか、書き直すか、あるいは機械翻訳の下書きを破棄して一から翻訳し直すかという判断です。ライト(軽微)かフル(完全)かといった指示の曖昧さが、この判断をさらに難しくします。エディターは「可能な限り変更を加えない」という基準を満たそうとして修正を控えすぎるか、指示書よりもプロとしての品質基準が高いために過剰な修正(オーバーエディット)をしてしまうかのどちらかに陥りがちです。
- 機械のフレーミングからの脱却。ポストエディターは白紙に向き合うわけではありません。最初に提示された訳案を読み、その案によって語彙や構文、解釈が縛られて(アンカリングされて)しまいます。プロのワークフローを対象とした研究でも、プライミング効果の存在が確認されています。機械翻訳に含まれる誤りやぎこちない言い回しがポストエディット後の訳文に残ってしまったり、修正作業そのものの方向性を左右してしまったりするのです。文章の響きが良いほど、その組み立て(フレーミング)が誤っていることには気づきにくくなります。これは、機械翻訳にLLMを利用する場合に特に顕著に見られる現象です。
- 誤った生産性の前提下での作業。MTPEの料金は、機械翻訳の出力によって人間の作業負荷が一定の割合で減るかのように設定されることが少なくありません。しかし、実際は異なります。難易度はセグメント、言語ペア、専門分野、誤りの種類によって変動する一方で、スピード重視の料金モデルのもとでは、クライアントが完璧さを求めている場合でも用語調査を行う余裕が奪われがちです。その結果、作業負荷のばらつきを翻訳者がすべて引き受けることになります。平易なセグメントなら低い単価にも見合いますが、難しいセグメントが、削減できたはずの分を人知れず帳消しにしてしまいます。
フォーマット、用語の制約、ロックされたセグメント、ロケール規則への対応も依然として重要ですが、これらは用語集、スタイルガイド、翻訳メモリなどを活用し、ワークフローの上流段階で制御しておくべき要素です。
MTPEの本当の問題は、判断力をどこに使うかです。流暢な誤りを見抜くこと、適切な介入の度合いを選ぶこと、機械によるアンカリングに抗うこと。そして、その3つすべてを、料金モデルに品質を決めさせずにやり遂げることです。
だからこそ私はすぐに、一括処理された訳文を後から手直しする画面よりも、早い段階から人間が関わるインタラクティブなワークフローのほうが良い効果をもたらす、という結論に至りました。しかし、業界はすでにその結論にたどり着いているのではないでしょうか?
MTPEの品質測定方法:BLEUとその先にあるもの
MTPEには測定に関する課題があります。品質には主観的な側面があるためです。業界で最も広く知られている自動評価指標はBLEU(Bilingual Evaluation Understudy)であり、機械翻訳の出力を人間が作成した1つ以上の高品質な参照訳と比較して評価します。
その仕組みは、機械翻訳の出力を通常1~4語の短い単語の連なり(n-gram)に分割し、それらが参照訳にどれだけ含まれているかを測定するというものです。同一単語の過剰な繰り返しによるスコアのつり上げを防ぐために一致回数には上限が設けられており、さらに訳文が不自然に短い場合にはペナルティ(brevity penalty)によってスコアが下がります。
BLEUはこれらの重複度合いの測定値を0から1の間のスコア(一般的には0~100で表示)にまとめます。スコアが高いほど参照訳と言い回しが近いことを意味しますが、必ずしも意味として優れているとは限りません。
個人的な意見を言えば、2026年現在においてBLEUはそれほど有用な指標とは言えません。その理由は次のとおりです。
BLEUスコアを有意に比較できるのは、同一のデータセットかつ同一のスコアリング設定でエンジンをテストした場合に限られます。そのため、「50なら優れており、10なら劣っている」といった普遍的な基準値は存在しません。BLEUの実用的な価値は、条件を統一した導入前後の比較にこそあります。
TAUSの事例研究では、法務という狭い専門分野の172,980件のフランス語・ドイツ語セグメントを学習させたところ、BLEUスコアが7.23ポイント上昇し、19%の相対的な改善が見られました。また、別のロシア語・英語の航空分野の事例では、クレンジングされた100万件のセグメントを含む翻訳メモリを活用したことで、Globaleseのスコアが23.6からほぼ51まで跳ね上がり、相対改善率は115.5%に達しました。改善の規模は分野、言語ペア、ベースとなるエンジン、データの品質によって大きく異なりますが、どちらの事例も、関連性が高く丁寧にクレンジングされた翻訳メモリが汎用的なトレーニングデータを上回り得る理由を物語っています。
しかし、BLEUは類似度スコアであって、正しさを示すスコアではありません。自信に満ちた流暢な誤訳が高いスコアを獲得することもあれば、参照訳と一致しなかっただけで全く問題のない優れた別表現が低いスコアを付けられることもあります。したがって、BLEUが定めるのはあくまで「最低基準」(機械翻訳の生出力が一定の形を保っているかの確認)にすぎず、訳文が正確か、ブランドのトーンに沿っているか、そして公開しても安全かどうかを最終的に判断するのは、今も人間のレビューです。
BLEUを補うために「LLM-as-a-judge(LLMによる評価)」による品質推定を併用するチームも増えていますが、それだけではあまり意味がありません。
従来行われてきたMTPEの落とし穴
現状の説明はここまでにして、ここからは私の主張を述べたいと思います。その要点は次のとおりです。
2ページ目で下した判断、たとえば「この登場人物は丁寧な話し方のままにする」「この駄洒落は地元の政治家に言及する形に作り直す」「この地名はラテン文字に転写しない」といった判断をフィードバックすれば、ドキュメントの残りの部分を再生成できます。
例文の提示やマルチショットプロンプティングは、高度なコンテキストエンジニアリングを行わなくても、また文脈が100%一致していなくても、LLMに驚くべき効果をもたらします。Transeptの社内ベンチマークでは、「別の」言語であっても該当ジャンルの適切な例文を含めるだけで、大幅な品質向上が見られました。
まず機械ですべて翻訳してしまうと、後から人間が一部を破棄するようなページの生成に計算リソース(クレジット)を消費することになります。そのうえ、機械が一度出力した無機質な訳文を後から無理やり手直しするために、人の貴重な時間を浪費することになるのです。
さらに、モデルの処理速度は人間よりもはるかに高速です。人間が作業を開始する前に、1万語すべてを下書きしておく必要はありません。
より優れたMTPEワークフローとは、最初の2,000語ほどを生成し、重要な判断をまず翻訳者に委ねてから、その判断内容と翻訳メモリをコンテキストに含めて残りの生成を進めるというものです。翻訳者がまだ5ページ目を作業している間に、裏でそれが進みます。Transeptのテストでは、未翻訳の原文に対して翻訳者の全体的な方向性を捉えたわずかなコメントを残しておくだけでも、その後の出力品質が数値で確認できるほど向上しました。
誰かが手直ししなければならない均一で粗悪な訳文が一括して届くのではなく、後続のページは前のページでの判断があらかじめ反映された状態で生成されてきます。
だからといって、MTPEそのものが間違っているわけではありません。重要度の低い大量のテキストであれば、一括で翻訳を通した後にライトポストエディットを行う手法が効率的です。もっとも、作業者にとって快適な仕事とは言えませんが。
しかし、コンテンツが重要な場合、一括処理モデルでは得られたはずの品質もお金も取りこぼしてしまいます。それでもこのモデルが選ばれるのは、短期的には反復するほうが高くつくように感じられるからです。
ですが実際には、たいていそうではありません。
より優れたアプローチ:早い段階で人間を関与させる
これまでに述べた内容はすべて、同じ一つの方向性を示しています。機械が全体の下書きを生成しきってしまう前に、人間の判断をシステムに取り入れ、その判断を翻訳メモリによって後続の処理へと引き継がせることです。具体的には、次の4つの実践が大きな効果をもたらします。
翻訳者である前に、まず編集者になる。何かを生成する前に原文を読み、重要な箇所に明確な方針を示すメモを残します。「このジョークは必ず残す」「この用語は極めて重要」「意味を保つため、ここでは原文から離れてよい」などです。そのメモと翻訳メモリを踏まえたうえで、下書きを生成します。
あらかじめ意図を汲み取った下書きをポストエディットする作業は、文脈のない無機質な訳文を手直しするよりもはるかに負担が少なくなります。自分の本で両方のやり方を何度も試した者として、そう言えます。
最高の訳文を翻訳メモリに蓄積する(お使いの機械翻訳が対応している場合)。AI活用において、翻訳メモリの価値は過小評価されがちです。難解な一節や扱いにくい言語ペアの場合、短い抜粋をいくつか完全に手作業で翻訳し、メモリに取り込んでみてください。モデルは、どれほど言葉を尽くした指示よりも、実際の具体例から文体や語調(レジスター)を的確に学習します。
長いテキスト全体の文体を一貫させるには、翻訳メモリだけでも十分な効果を発揮します。適切な過去の訳例を見つけ出すこと(セマンティック検索とあいまい検索の組み合わせ)自体が一つの職人技ですが、優れた訳例を作り出すのはさらに難易度が高い作業です。また、一つの文の訳し方として統計的に妥当な表現は無数に存在し、どれが自らのスタイルに合っているかは書き手本人にしかわからないため、ここでも人間のディレクションが欠かせません。
とはいえ、翻訳メモリを活用して質の高い文章を生成できるツールばかりではありません。Transeptでは広範な研究を重ね(AIローカライズにおける翻訳メモリに関する論考にまとめています)、人間が承認したセグメントやその背景にある文脈・作業履歴が、LLMによる翻訳品質の向上につながるように設計しました。
単一の大型モデルではなく、複数のモデルを順次活用する。学術研究とTransept社内の検証の双方で一貫して示されている結果があります。それは、AIの役割を段階的に連鎖させるアプローチが、1つの強力なモデルで一気に処理するよりも、品質とコストの両面で優れているということです。
まずは低コストで高速なモデルを使って下書きを作成します。次に、高性能なモデルにその下書きを読ませて改善点に関するコメントを残させます。そして、そのコメントを再び高速なモデルに反映させます。
この方法のほうが、高性能なモデルにすべてを任せるよりも低コストであることが分かっています。さらに、多くの場合、品質も向上します。高性能なモデルと軽量なモデルの組み合わせが、大型の高性能モデル単体よりも優れた出力を生み出すとは信じがたく、これは私にとっても大きな驚きでした。
しかし、実際に機能するのです。私の仮説では、批評と生成は別の仕事であり、活性化パターンも異なります。両者を切り分けることで各モデルの強みが活かされ、「認知的負荷」が軽減されて、作業に集中しやすくなるのだと考えています。
要するに、これこそがマルチエージェントパラダイム全体の基盤です。異なる設定やタスクを与えてインスタンス化することで、モデルは自身が犯した誤りを自ら修正できるようになります。
基盤(配管)を適切に整える。真のパフォーマンスはチャットアプリからではなく、APIから引き出されます。チャットアプリの肥大化したシステムプロンプトや製品の足場となる機能は、かえって処理の妨げになります。
LLMの出力が翻訳者から過小評価されがちなのは、「調理法」が間違っているからです。それはまるで、濃口醤油とゴマだれで仕上げたマグロのステーキが、味気ないツナ缶とは似ても似つかないのと同じです。
入力を整理してクリーンかつキャッシュしやすい状態に保てば、コストとレイテンシの双方が低減します。モデルが追加のコンテキスト(翻訳メモリ、判断履歴、スタイルガイド)を適切に処理できるかをテストし、ベンチマークが低下し始める限界まで情報を与えてみてください。LLMに対して適切なアプローチをとれているかを真に見極めるには、複数言語での優れたベンチマークが不可欠です。
Transeptでは、この仕組みを突き止めるために、自らの文章を使って3年間にわたり研究と実験を重ねてきました。
自作の小説を翻訳していたときに欲しかったツール:MTPEに対するTranseptの答え
技術的な素養があり几帳面な翻訳者なら、モデルAPIと翻訳メモリを使い、根気よく取り組めば、このワークフローを自力で再現できます。しかし、人間をプロセスに関与させるMTPEを「見事に」機能させ、心地よい作業体験と優れた成果を両立させるには、かなりの研究が必要です。
私たちがTranseptを開発したのは、自分たちの長編作品を翻訳する中で、そうした要素を手作業で組み合わせる工程に強いもどかしさを感じ続けていたからです。
ここまで述べた構想を、私たちは1つのワークスペースにまとめました。早い段階でモデルに明確な指示を与え、下した判断を蓄積し、役割ごとに特化した処理を順次実行し、ブロックや文の単位でレビューできるようにしています。
生成する前に指示を与える。ドキュメントエディターでは、原文、訳文、周囲のコンテキストが常に一元管理されます。翻訳者はほかの部分を崩すことなく、ブロックにコメントを残したり、指示を添えて1文だけを再生成したり、代替候補を比較したり、手動で編集したりできます。コメントやレビューのスレッドはテキストに紐づいたまま残るため、「比喩をそのまま維持する」といった指示もチャットログに埋もれず、判断として残ります。
「却下」した候補でさえも記録に残ります。不採用とした言い回しや、それを選ばなかった理由のメモも、次回の処理で再利用されるコンテキストの一部となります。詳細は翻訳候補や、翻訳メモリが過去の判断をコンテキストとして活用する仕組みをご覧ください。
判断をメモリに変える。Transeptの翻訳メモリは、承認された訳文と、その判断に至った背景のコンテキストを以降の作業に引き継ぎます。用語集は人名、製品用語、決まった訳語を固定し、スタイルガイドはトーン、文体、リズム、表記ルールを保持します。どちらも、信頼できる過去の成果物やクライアントのブランド資料から自動生成でき、AIに適用する前に内容を確認できます。
処理工程を切り分ける。1つのモデルに翻訳、評価、推敲を一度に任せるのではなく、Transeptはそれらのタスクを順次実行できます。Smart Proofreadは、原文、用語集、スタイルガイドと照らし合わせながら訳文を再読し、抜け落ち、用語のブレ、文体の乱れをレビュー可能な修正候補として提示します。
また、手作業による細かな調整よりも全体の連動性を重視したい場面向けに、翻訳、校正、推敲、品質チェックを一括して処理する翻訳、校正、ブラッシュアップなどのワークフローも用意しています。同一ドキュメントの複数言語バージョンに対してもそのまま活用できます。
長大なドキュメントに対しては、複数のエージェントが同一のドキュメントで協調して作業できる仕組みも開発しました。各エージェントはスタイルガイドや用語集を共有・更新し、特別な段階的メモリによって相互の判断を同期させます。
レビューは部分ごとに、展開は全体に。ポストエディットはブロックや文の単位で完結します。候補の比較、1行だけの再生成、修正案の承認、手作業での書き換えなど柔軟に対応できます。Literessがワークフローの実行を支えてブレを検知し、一括翻訳はスプレッドシートのような無機質な管理に頼ることなく、共有のコンテキスト、用語集、スタイルガイド、品質チェックを多数のファイル全体に適用します。
また、標準の処理フローが希望する順序と合わない場合は、ステップごとに独自のワークフローを作成できます。必要なステップを選び、レビュー用のゲートを設け、事前に費用を確認した上で実行できます。
Transeptで私たちが成し遂げてきた成果を、私は心から誇りに思っています。これらの機能は、人間の貴重な時間と才能がLLMの働きに与える影響力を、最大限に引き出す助けとなります。
これらすべてを実現可能だと考えていたプロの翻訳者が、ごくわずかしかいなかったことには今でも驚かされます。技術的には、対話型のMTPEワークフローを構築することは2023年の時点で可能でしたし、この技術はまだ始まったばかりの段階にすぎません。
MTPEのベストプラクティス:チェックリスト
たとえTranseptに関心を持っていただけなかったとしても(それは少し残念ですが)、MTPEについて知っておくべきこと、そしてその作業の苦痛を和らげるためのポイントをここにまとめました。
- 早い段階で人間を関与させる。生成後ではなく生成する前に、重要な箇所へ明確な指示を残しておきます。
- 実際の具体例をメモリに蓄積する。最も難解な短い抜粋をいくつか手作業で翻訳し、モデルにそこから文体を学ばせます。
- 複数のモデルを段階的に連鎖させる。低コストなモデルで下書きし、高性能なモデルで批評し、高速なモデルで反映します。この方法なら、単一の大型モデルよりも品質とコストの両面で優れています。
- コンテンツを階層分けする。目立たない大量のテキストには完全な一括MTPEを適用し、ブランド価値に関わる部分は反復しながら仕上げます。
- 上流で用語ルールを徹底する。翻訳対象外や使用禁止の訳語に関するルールを設定することで、最も頻発し、かつ深刻なミスを発生源で防ぎます。
- 地域差や文体の乱れに注意する。地域差による表現、敬体や常体の使い分け、代名詞の一貫性こそが、ネイティブにとって自然な翻訳と、継ぎ接ぎだらけの訳文とを分ける境界線です。
- 流暢なテキストほど厳しく品質チェックする。機械翻訳の出力が自然に読めれば読めるほど、抜け落ちは見落としやすくなります。
MTPEがなくなることはありませんし、膨大な量のコンテンツにとって適切な手段であることも確かです。しかし、一括生成してから後で手直しするというパイプラインは、翻訳技術の歴史における誤った道筋と言えます。
概念としては簡単に解決できます。早い段階で人間を関与させ、実際の具体例やメモリでコンテキストを補強し、低コストなモデルに下書きさせながら高性能なモデルで批評する。これだけで、より優れた翻訳を低コストで実現できます。それこそが、翻訳会社と翻訳者の双方が恩恵を受けられる形です。
人間を早い段階で関与させるプロセスを実際に試してみたい場合は、ドキュメントの翻訳から始めてみてください。カード不要のFreeプランで、最初の翻訳をお試しいただけます。
まずは質問してみたいという場合は、Literessにお尋ねいただくか、このガイドをご覧いただいた場所から私宛てにお気軽にご連絡ください。
著者
Transept共同創業者。ペンネーム「Mevkh」名義で執筆。言語学・文学の学位を取得後、ソフトウェア開発へと転向。シニアAIエンジニアとして、RAG、エージェント型ツール、LLM-as-judgeによる評価など、実用的なLLM機能を50,000人以上のユーザーに提供してきました。小説家としてはじっくり創作を進めるタイプで、机の引き出しには12万語に及ぶ風刺ロマンスファンタジーが眠っています。AI翻訳と自身の書いた散文との間で生じた摩擦こそが、すべての始まりでした。