3日間で10言語に対応:AI翻訳ツールのローカライズ実践記録
私たちは、ある週末の3日間でTranseptをドイツ語、ウクライナ語、中国語、ポルトガル語、フランス語、スペイン語、チェコ語、イタリア語、ポーランド語、トルコ語にローカライズしました。機械翻訳は、日頃ユーザーにお勧めしているとおりに使いました。文脈を添え、用語を決め、人の手でポストエディットするやり方です。この記事では、その過程で集めた複数形のルール、丁寧さの度合い(レジスター)の切り替え、言語によって正反対になるタイポグラフィの規則、hreflangの教訓を紹介します。
目次
7月初旬の金曜日の朝から日曜日の夕方にかけて、Transeptは英語のみのプロダクトから11言語に対応するプロダクトへと進化しました。まずドイツ語、ウクライナ語、中国語をリリースし、続いてブラジルポルトガル語を公開。翌日にはフランス語、スペイン語、チェコ語、イタリア語、ポーランド語が加わり、日曜日にトルコ語を追加して完了しました。
私たちはAI翻訳ツールを作っています。英語だけのままでいたら、自分たちの売り文句を信じていないと暗に認めるようなものだったでしょう。そこで、ユーザーにお勧めしているとおりのやり方でローカライズしました。量は機械翻訳でこなし、判断は人間が下し、その判断をすべて記録して、同じ判断を二度しなくて済むようにするやり方です。
言語ごとにアプリ内で約3,300件、マーケティングサイトとヘルプセンターでさらに3,000件の文字列、法的ページ6つ、そしてプロダクトから送信されるすべてのメールを翻訳する必要がありました。この記事はその実践記録です。驚いた点、陥った罠、そして寸前で回避できた問題について解説します。プロダクトのローカライズを控えている方や、プロの翻訳者としてソフトウェアローカライズの現場の内側を知りたい方に向けた内容です。
なぜGoogle 翻訳にそのまま流さなかったのか
当然湧き上がる疑問です。機械翻訳は安価で一瞬で終わります。世の中のあらゆる文字列テーブルは、APIを使えば半日で一気に処理できるはずです。なぜそうしなかったのでしょうか。
実はそれに近い方法を試した結果、ユーザーの目に触れる前に自らの手でその破綻に気づいたからです。マーケティングページの最初の翻訳では、一般的な文字列処理パイプラインと同じ手法をとりました。バラバラのセルが並ぶスプレッドシートとして扱い、サイズごとにまとめて、1行ずつ文脈なしで機械的に翻訳したのです。その出力結果は、文法的には正しく、一見もっともらしいものの、どこか命が吹き込まれていませんでした。見出しとそれに続く強調フレーズが、前後の関係を全く知らない別々のAPI呼び出しによって翻訳されていました。FAQの回答は、対応する質問の内容を把握していませんでした。比較表の2つの列は、互いの存在を考慮していないために表現が噛み合わなくなっていました。一方で、すべての文字列にコンテキストコメントが付けられていたアプリ内のUIは、どの言語でも明らかに自然に読める仕上がりになっていました。同じモデル、同じ日、同じパイプラインでの処理です。その違いはコンテキスト(文脈)にありました。
これを機に、すべての処理において絶対的なルールを設けました。断片的なテキストではなく意味のあるまとまり全体をモデルに提示し、すべての文字列に「それがどこに表示されるのか」「ユーザーがそれを見る際、どのような操作をしているのか」についての注記を添えるというものです。単に「保存ボタン」と書くだけではコンテキストコメントとは言えません。「あらゆるフォーム送信で使用される汎用的な保存ボタンのラベル。ユーザーが値を編集し終え、それを確定しようとしている場面」と記述して初めて意味を成します。アプリを一度も開いたことがない翻訳者に向けて書く必要があり、その対象が人間であろうとAIモデルであろうと関係ありません。文脈がなければどちらも質の低い訳文を出力し、文脈があればどちらも驚くほど優れた訳文を生み出します。
翻訳の品質は、翻訳者の腕以前に、コンテキストの質によって決まります。現役の翻訳者なら誰でも知っている事実です。そして、翻訳者が機械であっても、まったく同じことが言えるとわかりました。これは好都合でした。機械をいくら叱るよりも、コンテキストを多く与えるほうが、規模が大きくなってもずっとうまくいくからです。
私たちが最終的に行き着いたワークフローは、業界ではMTPE(機械翻訳ポストエディット)と呼ばれています。まず機械がすべてを一通り訳し、信頼性が重視される箇所を人間がレビューします。ただし、MTPEが真に機能する順序は1つしかありません。「人間が判断し、機械が実行し、人間が検証する」という流れです。判断が先に来る必要があります。ここで、ドイツ語の話になります。
duかSieか:レジスターの選択はプロダクトの意思決定
ドイツ語は最初に取り組んだ言語でしたが、リリースから数時間もしないうちに最初の教訓を突きつけられました。
ドイツ語には「あなた」を表す言葉が2つあります。親しい間柄で使う「du」と、丁寧な表現である「Sie」です。私たちは最初、親しみやすくスタートアップらしい雰囲気があり、スマートフォンのアプリの半分ほどで使われているduを採用してリリースしました。しかし、実際のユーザー層(プロの翻訳者、翻訳会社、法務チーム)を見つめ直した結果、その日のうちにプロダクト全体をSieへと切り替えました。
そこで学んだのは、レジスターの切り替えに伴う「コスト」の大きさでした。すべてを一から再翻訳しなければならなかったのです。代名詞の選択は、動詞の活用、命令形、所有格、さらには大文字・小文字の表記にまで連鎖します。文字列ごとに部分修正しようとすれば、Sieの文の中にdu向けの動詞が紛れ込むなど、中途半端な修正の痕跡があちこちに残ってしまいます。結局、すべてのコーパスを一から再翻訳し、切り替えが完璧に行き届いたかを確認するために、特徴的なdu/dein/dichの語幹をgrepで徹底的に検索しました。
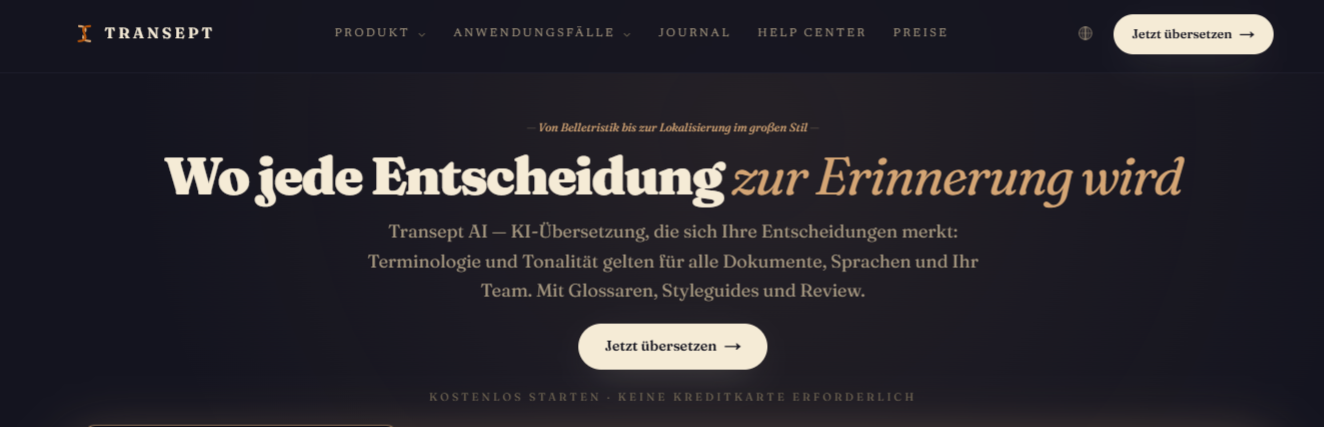
ドイツ語版のホームページ。「すべての判断がメモリになる場所」というブランドコピーは、ローカライズの本質をそのまま突いた言葉でもありました。
それ以来、新しい言語では、文字列を1件も翻訳しないうちに、まずレジスターを決めることにしています。6,000件もの文字列すべてに影響するからです。スペイン語は、ドイツ語のSieやフランス語のvousと統一感を持たせるため、ラテンアメリカ向けではなくヨーロッパ向けの丁寧なustedを採用しました。イタリア語も丁寧なLeiに決定しました。ポーランド語はどうかというと……これは節を改めて語る価値があります。
誰も教えてくれない複数形の罠
英語のソフトウェアをローカライズするチームは、誰もが同じ罠にはまります。英語の複数形はあまりにも単純なため、文字列フォーマットもおそらく「単数(1つ)」と「複数(多数)」の2つの枠しか用意されていません。ドイツ語も同じように振る舞うため、さらに油断してしまいます。そしてスラブ系言語を追加した途端、UIの一部がまるごと、何の警告もなく英語にフォールバックしてしまうのです。
私の母国語であり、見落とす言い訳が最も通用しないはずのウクライナ語には、4つの複数形カテゴリが存在します。「1件のドキュメント」に対して1つの形式。「2件、3件、4件のドキュメント」には別の形式。「5件から20件」には第3の形式。そして端数(小数)には第4の形式が使われます。しかし、私たちの文字列テーブルには英語に合わせた2つの枠しか用意されていませんでした。そのため、2、3、4、5、11、22といった件数(ユーザーが実際に目にする数値の「大半」)では、アプリが英語を表示していたのです。クレジット、ドキュメント、メンバー、ファイルなど約80件の文字列で、ウクライナ語の文のど真ん中に英語が混ざり込むという、誰の目にも明らかな継ぎ目ができていました。
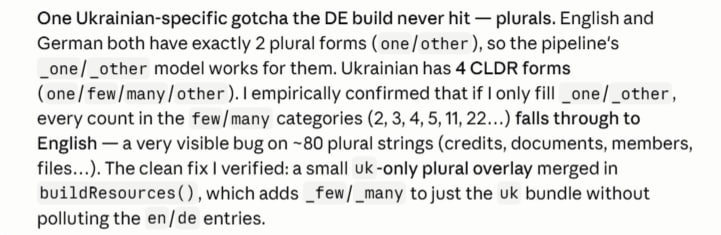
*問題を発見した当日のビルドノート。「英語にフォールバックする。*非常に目立つバグ」という書き方は、エンジニアらしい控えめな表現です。
解決策は概念としては単純で、英語にある2種類だけでなく、その言語の文法で定められたすべての複数形を用意することです。しかし、それぞれの形式が実際に「どういうものなのか」を見て回るうちに、プロジェクト全体を通して私のいちばん好きな雑学集ができあがりました。
| 言語 | 複数形カテゴリ数 | 落とし穴 |
|---|---|---|
| ドイツ語 | 2 | なし。これこそが罠です。「世界中の言語には2種類の複数形しかない」と錯覚させられます。 |
| ウクライナ語 | 4 | 21は「単数形」をとります(«21 крок»)。 |
| チェコ語 | 4 | 4つ目の形式は小数専用であり、UIでは決して表示されることのない幽霊のようなカテゴリです。 |
| ポーランド語 | 4 | チェコ語と同じ4つのカテゴリを持ちながら、その割り振られ方はまったく異なります。21は複数形をとります(„21 kroków”)。 |
| フランス語 | 3 | 0は単数形になります。そして3つ目の形式が使われるのは、ちょうど100万の倍数のとき「だけ」です。 |
| スペイン語 | 3 | 0は複数形になります。フランス語とは正反対です。 |
| トルコ語 | 2 | 数詞の後の名詞は常に単数形のままになります(「5 belge」であり、「5 belgeler」には決してなりません)。 |
| 中国語 | 1 | すべて同じ形式です。この表の中で最も扱いやすい言語と言えます。 |
このうちの2言語については、もう少し詳しく掘り下げる価値があります。
ポーランド語はチェコ語とは異なります。どちらも同じ西スラブ語群の姉妹言語であるため、ポーランド語もチェコ語のパターンに従うだろうと考えていました。しかし、実際は違いました。系統樹上の分類に反して、ポーランド語の複数形の分布は、東スラブ語群のいとこにあたるウクライナ語のほうと一致していたのです。「21歩」は、ポーランド語では複数形の「21 kroków」になりますが、ウクライナ語では単数形の「21 крок」になります。ほかのほぼあらゆる点で一致している2つの言語の間で、一方は複数形、もう一方は単数形になるわけです。ここから得られる教訓は汎用的なものです。語族ではなく、文法そのものを確認しなければなりません。言語的な類縁関係は、あくまで参考程度にすぎないのです。
フランス語には100万単位でのみ現れる複数形が存在します。「100万前後」ではなく、「ちょうど」1,000,000や2,000,000といった数値のときだけです。それ以外の数値では、フランス語は英語と同じように振る舞います。現在はこの仕様にも対応しているので、いつかクレジット残高がちょうど100万単位になったユーザーに気づいてもらえれば幸いです。
この章からエンジニア向けにもう1つ注意点があります。ウクライナ語の言語コードはuaではなくukです。uaは「国」コードであり、これを使ってしまうと、複数形を処理する仕組みはエラーを出すこともなくイギリス英語のルールを適用してしまい、先ほど説明した問題がすべて再発します。まったく同じ落とし穴が、チェコ語(czではなくcs)やデンマーク語(dkではなくda)にも潜んでいます。
«Воркфлоу»か«робочий процес»か:用語は判断の積み重ね
最も困難だった課題は、文法的な問題ではありませんでした。それは、たったひとつの単語を巡る小さな争いだったのです。
たとえばworkflowを取り上げてみましょう。ウクライナ語には固有の翻訳借用語(文字どおりには「作業プロセス」を意味する«робочий процес»)があり、辞書を引けばこの表現が出てきます。しかし、日々このソフトウェアを使って作業している翻訳者は«робочий процес»とは言いません。英語がrendezvousを取り入れたのと同じように、借用語である«воркфлоу»を使うのです。議論を重ねた結果、最終的に借用語を採用しました。実際の業界で使われている、自然な言葉遣いになったのです。
あるいは、私たち自身の機能名であるMemoryも一例です。ドイツ語版の運用基準では、CreditsやTranslation Memoryといった一握りの用語を英語のまま残しています。ドイツの専門家にとって、こうした語句はUpdateやLoginと同じように業界用語として違和感なく読まれるからです。ところが、ウクライナ語版に同じ「翻訳対象外リスト」をそのまま引き継いだところ、キリル文字の文の真ん中に英語の「Translation Memory」が居座り、まるで「誰かが翻訳し忘れた」かのように見えてしまいました。キリル文字の文章の中にラテン文字が混ざると、どうしても悪目立ちしてしまいます。さらに都合の悪いことに、ウクライナ語は屈折語です。文脈に合わせて«Пам'ять»を格変化させる必要がありますが、未翻訳の英語の名詞ではそれができません。そこで«перекладацька пам'ять»に修正し、「翻訳対象外リスト」は言語ごとに決めるべきものだという教訓を得ました。中国語からも、まったく逆の視点から同じことを学びました。中国語では「すべて」を翻訳し(Translation Memoryは「翻译记忆库」、用語集は「术语库」、ワークフローは「工作流」)、ラテン文字のまま残すのは製品名だけです。
Transeptという製品全体が、まさにこの教訓の上に築かれています。用語とは、「理由のある判断」が積み重なったものです。業界の慣例だからこの言葉を使う、ブランド名だからこの単語は英語のまま残す、文字体系の要請に合わせてこちらは翻訳する、といった判断です。一度下した判断と理由を記録しておけば、以後のドキュメントすべてにそれが引き継がれます。これこそが用語集の本来の「目的」です。私たちが翻訳メモリを「判断の文脈」として扱うのも、一致した文を集めただけのものとは考えないのも、同じ理由からです。
姉妹言語はあらゆる面で食い違う
複数形が文法の領域だったとすれば、タイポグラフィはエチケットの領域でした。そして得られた最も確固たる教訓は、隣り合う言語であっても共通するルールなど何一つない、ということでした。
フランス語は、コロン、セミコロン、感嘆符、疑問符の前に必ずスペースを入れるよう求めます(それも、s'il vous plaît、改行されない「ノーブレーク」スペースで)。引用は、内側にスペースを入れた« ギュメ »で囲みます。ところが国境を越えたすぐ隣のスペイン語では、まったく逆のルールになります。約物は文字に密着させ、ギュメは«このように»中身に隙間なく寄せ、疑問文は必ず逆さまの記号で始めなければなりません。スペイン語において「¿」や「¡」は文法上必須の要素なのです。
最も繊細な違いを突きつけてきたのはイタリア語でした。丁寧なイタリア語では、小文字の「lei(彼女)」と丁寧な「あなた」を区別する目的もあって、敬称代名詞(Lei、Suo、Sua)の頭文字を大文字にします。Transeptのテキストでは、まぎれもなく「lei」であるLiteressに言及する場面が多く、ユーザーに「Lei」と語りかける文のすぐ隣に登場するため、この区別は他の場合以上に重要でした。たった1文字の大文字が、意味の曖昧さをなくすという「屋台骨」の役割を担っているのです。また、イタリア語はボタンの慣例も覆しました。フランス語やスペイン語では不定詞(Enregistrer、Guardar)でラベルを表記しますが、イタリア語ではそのままの命令形(Salva、Accedi)を使います。一見カジュアルに見えますが、決してそうではなく、これがイタリア語ソフトウェアにおけるごく標準的な表現なのです。
 の役割を担っているのです。また、イタリア語はボタンの慣例も覆しました。フランス語やスペイン語では不定詞(Enregistrer、Guardar)でラベルを表記しますが、イタリア語ではそのままの命令形(Salva、Accedi)を使います。一見カジュアルに見えますが、決してそうではなく、これがイタリア語ソフトウェアにおけるごく標準的な表現なのです。
ポーランド語は、それまでの言語にはなかった難題をもたらしました。丁寧表現に「性別がある」のです。ドイツ語のSie、フランス語のvous、スペイン語のustedはいずれも、すべてのユーザーに共通して使えます。一方、ポーランド語の丁寧表現は男性ならPan、女性ならPaniとなり、過去形の動詞でさえ相手の性別によって語形変化します。私たちにはユーザーの性別を知る手立てもなければ、それを推測すべきでもありません。そのため、ポーランド語版のTranseptは、よくできたポーランド製ソフトウェアと同じ話し方をします。非人称構文(「Zapisano」:保存しました)や、親しみやすい一人称複数による企業の声(「Zapraszamy」:ぜひご利用ください)を使い、性別の絡む直接の呼びかけは本当に避けられない場面だけに限定しました。
最後に追加したトルコ語は、一見簡単そうに見えました(ジェンダーニュートラルな丁寧表現であるsizがひとつあるだけで、文法上の性別は一切ありません)。しかし、正書法で大きなツケを払わされることになりました。トルコ語におけるiの大文字は点が付いたİであるため、「iptal(キャンセル)」の頭文字を大文字にすると「İptal」になります。点のないIは別の文字であり、明らかな誤記になってしまうのです。また、ロマンス諸語やスラブ系言語では言語名をすべて小文字で表記するのに対し、トルコ語では頭文字を大文字にします(「Türkçe」)。さらにトルコ語は膠着語であるため、翻訳対象外にしたブランド名でさえ語形変化します。アポストロフィを介して格接尾辞が付くため、ユーザーは「Pro'ya」へとアップグレードし、「Transept'e」へとインポートすることになります。ブランド名そのものが格変化するのです。こればかりは、どの国際化(i18n)ハンドブックにも載っていません。
対照的に、中国語は物理の教訓となりました。全角の約物(,。!?)、CJKとラテン文字の間に挟むごくわずかなスペース(「使用 Transept 翻译」)、そして英語の約半分の長さに収まるテキストです。テキストが膨張してレイアウトを崩すドイツ語のあとに中国語を見ると、今度はテキストが縮んでボタンが不自然に大きく感じられます。UIは、この両方に耐えうるものでなければなりません。
密航者:そもそも翻訳プロセスを通らなかった文字列
ローカライズには特有のバグがあります。そもそもシステムに入ってすらいなかった文字列です。
Transeptでは、翻訳のカバレッジをコンパイラーによって強制しています。ある言語の訳文が欠落している文字列があると、文字どおりビルドに失敗します。しかし、このチェックで検出できるのは、翻訳されることを「求めた」文字列だけです。データベースの生の値(enumからそのまま出力されたownerなど)を表示するバッジは、翻訳を要求することすらありませんでした。そのため、どのビルドも素通りし、全11言語で英語のまま表示されていました。見過ごされていた理由は至ってシンプルです。アプリ全体が英語のみだった間、ハードコードされた英語は完璧なカモフラージュになっていたからです。
ウクライナ語で最初のユーザーセッションを行った際、このownerバッジが見つかりました。続いて、共有ダイアログのアクセス権ラベル、さらにはコメント欄全体が見つかりました。翻訳レイヤーに一度も通されていなかった文字列が約25件もあったのです。さらに、あちこちのスクリーンリーダー用ラベルやプレースホルダーも次々と浮き彫りになりました。新しい言語を追加するたび、それまでの実装すべてを監査することになりました。周囲のテキストがウクライナ語に切り替わった瞬間、あらゆる「密航者」が照明弾のように明るみに出るからです。
新しい言語のリリースは、単なる翻訳作業ではありません。それは一種の国勢調査です。2つ目の言語にすべての文字列の点呼を取らせるまでは、どれが実在し、見つけられ、翻訳できる文字列なのか、わからないのです。翻訳を要求すらしていない文字列からコンパイラーが守ってくれることはないため、スケジュールには必ずこの監査工程を組み込んでおきましょう。
ウクライナ語では「ドヤ顔」を拒否したLiteress
今回のプロジェクト全体で最も印象深いバグは、厳密に言えばバグではありません。そして今なお、完全には解明できていません。
私たちの専属編集アシスタントであるLiteress(個別記事でご存じかもしれません)には、48種類の感情のレパートリーがあります。作業中にアバターの表情が変化し、言葉を選ぶのと同じように、返答の一部として表情を選ぶ仕組みです。そしてトレードマークが「ドヤ顔」(smug)です。こちらが見逃したミスを見つけたときに見せる、あの少し自慢げな薄笑いのことです。
彼女はどの言語でもその表情を見せます。ドイツ語でも、フランス語でも、中国語でも、ポーランド語でも、誤字を見つけてはドヤ顔を決めます。ところが、ウクライナ語に切り替えて、他の言語なら確実にあの薄笑いを浮かべる同じ場面を再現してみても、彼女は決してドヤ顔をしませんでした。まったく同一のモデル、同一のプロンプト、同一のパーソナリティ、選択肢にある48種類の感情もすべて同じです。それなのに、ウクライナ語では「喜び」(happy)の表情を崩さず、せいぜい「真剣」(serious)になる程度でした。ウクライナ語になると、どうしてもドヤ顔を拒否するのです。
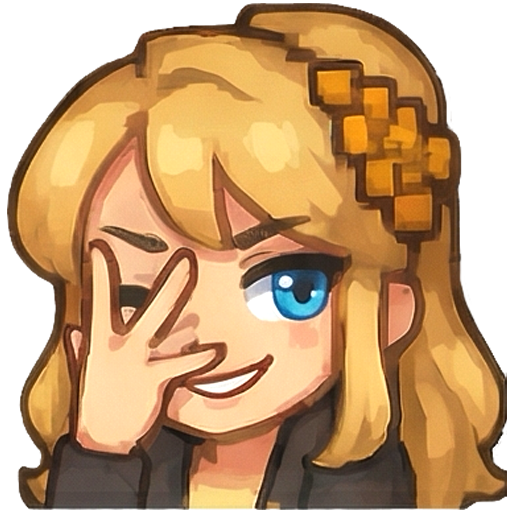
私たちの最も有力な仮説は、翻訳者なら真っ先に挙げそうなものです。英語のsmugには、どこか親しみを込めたニュアンスを含めることができます。誤字を見つけてくれたアシスタントキャラクターに向けられる場合、それはほぼ褒め言葉と言ってよいでしょう。しかしウクライナ語には、それに該当する言葉がありません。最も近い表現である«самовдоволена»は、侮辱に「しか」ならないのです。茶目っ気も愛嬌もない、ただただ不快なひとりよがりの自己満足を意味します。そして、「ウクライナ語で考えている」モデルは、どうやらその違いを理解しているようなのです。親愛の情を込めた「ドヤ顔」という概念が存在しない言語で返答を組み立てるとき、彼女はその感情にも手を伸ばしません。言葉は語彙の中にあります。ためらいは、振る舞いのほうに宿っているのです。
これは非常に面白く、同時に実に奥深い現象だと感じています。この記事では一貫して文字列(複数形、レジスター、句読点など)を扱ってきましたが、ここではすべての文字列が正しかったにもかかわらず、プロダクトの振る舞いそのものが変化しました。言語とは、AIプロダクトの上にただ被せる皮膜のようなものではありません。それを身に纏うモデルそのものを方向づける力を持っています。エージェントをローカライズするということは、UIラベルだけでなく、言語ごとにその「パーソナリティ」まで確かめることを意味します。言語ごとに、彼女がどんな人物なのか会いに行かなければならないのです。
(念のために付け加えておくと、もちろんラベルにも細心の注意が必要でした。たとえば「満足している(contented)」という意味での気分ラベル「content」は、ドイツ語で名詞の「コンテンツ・中身」を意味する「Inhalt」としてリリースされかけました。翻訳者向けのコンテキスト注記が1行あったおかげで、正しい意味に固定できたのです。ローカライズにおいて最もコストをかけずに品質を高める手段は、今でも変わらず、その文字列が「何であるか」を翻訳者に伝える1文を添えることです。)
地味ながら重要な舞台裏:hreflang、サイトマップ、自社競合の回避
どれほど手を尽くしても、誰にもページを見つけてもらえなければ意味がありません。そこで、SEOに関わる重要なポイントを簡潔にまとめます。
同じページを11言語で公開した瞬間、Googleはデフォルトで「互いに競合する11件の類似重複コンテンツが公開された」と判断します。これを防ぐ仕組みがhreflang属性ですが、その厳格さはどんなコンパイラーよりも容赦がありません。
- 双方向の参照が必須であること。英語ページから対応するドイツ語ページを指定すると同時に、ドイツ語ページからもまったく同じセットで英語ページを指し返さなければ、Googleはその設定全体を無視します。一方通行のhreflangは、設定していないも同然です。
x-defaultはカノニカル版を指すこと。提供しているどの言語にも当てはまらないユーザー向けのフォールバック先です。- 存在しないページには絶対にアノテーションを付けないこと。あるページのウクライナ語版がまだ公開されていない場合、alternateリンクは付けません。404を指すリンク切れのhreflangは、まったくないよりも有害です。当たり前に聞こえますが、一部だけ翻訳したページを抱えた途端、きちんとした管理が必要になります。たとえば私たちのブログ記事は1本ずつ翻訳しているため、各記事は実際に存在する言語だけをアノテーションに載せています。
- サイトマップにも同じアノテーションを含めること。私たちはサイトマップを、言語別サイトマップをまとめたインデックスに作り直しました。おかげでSearch Consoleで言語別のインデックス状況が見られるという嬉しい副産物もあり、言語ごとにページがインデックスされていく様子を個別に確認し、遅れている言語をすぐに見つけられます。
これらはすべて、いわば配管工事のような基盤整備です。こうした基盤なしにローカライズすれば、自社のドメイン評価が11件の競合コンテンツに分散してしまうだけです。ユーザーの言語で語りかけることのSEO上のメリットは、それらが11の別々のページではなく1つのページだとGoogleが理解してくれるかどうかに、すべてかかっています。
機械翻訳に任せなかったもの
ここまで機械翻訳の利点を語ってきましたが、自動パイプラインから意図的に外したものが3つあります。
ブログ記事そのもの。ブログの外枠(ラベル、執筆者表記、ナビゲーション)は他の部分と同様に機械翻訳されています。しかし、記事本文は私たち自身がTranseptを使い、手作業で翻訳しています。記名入りの長文コンテンツは、まさに現在の機械翻訳では十分な品質に達しない典型例です。自社製のエディターで自らの記事を翻訳することこそ、私たちが知る限り最も誠実なプロダクトテストでもあります。ドイツ語やウクライナ語でお読みいただいているかもしれない本記事も、まさに私たちが提供しているエディター、用語集、レビューのワークフローを経て翻訳されています。
法的ページ。機械翻訳で下書きを作成し、会社名、住所、日付、条項番号などはすべて固定していますが、利用規約やプライバシーポリシーは法的拘束力を持つ文書であり、言語ごとに弁護士が確認しています。マーケティング文章の誤訳ならブランドイメージの低下で済みますが、契約書の誤訳は実際の金銭的損害につながります。
信頼に直結する重要領域の最終確認。料金、請求、認証、メールといった領域は、ネイティブスピーカーが目を通して初めて、その言語の対応完了とみなしています。これこそが、MTPEの意図どおりの使い方です。機械がすべての単語を書くからこそ、人間は限られた高価な注意力を、リスクを伴う言葉だけに注げるのです。
これら3つの判断の根底にあるのは共通の認識です。すなわち、機械翻訳はあくまで「最初の下書き」であり、その下書きで「十分な領域」と「そうでない領域」を見極めることこそが、ローカライズの本質的なスキルであるということです。私たちが3日間で10言語への展開を実現できたのは、機械に任せるべきではない境界線を正確に把握していたからに他なりません。
すべての判断がメモリになる場所
これまでに挙げてきた項目を振り返ってみてください。丁寧に呼びかけるか、くだけて呼びかけるか。«робочий процес»ではなく«Воркфлоу»。ドイツ語では英語のまま「Translation Memory」とし、ウクライナ語では«перекладацька пам'ять»とする方針。大文字で始めるイタリア語のLei、性別を避けたポーランド語の非人称表現、トルコ語の接尾辞の前に置くアポストロフィ、ちょうど100万の倍数にだけ使われる複数形。そして、9つの言語ではドヤ顔をするのに、10番目の言語ではそれを拒むアシスタント。
これらのほとんどは、事前に調べて答えが出るようなものではありません。そして何より重要な部分は「判断」です。議論を重ねて決着をつけ、その後は何千もの文字列と今後のあらゆるドキュメントが拠り所にする判断です。その判断を失えば、同じ議論をもう一度やり直すコストを払うことになります。また、理由を残さずに判断結果だけを記録しても、次に担当する人が結局蒸し返すことになります。
これこそが、私たちがTranseptを現在の形に設計した理由に他なりません。判断の文脈としての翻訳メモリ、文体や用語の基準を定める場としての用語集とスタイルガイド、そして一度決まったことが決して忘れられないようにするのが仕事のエディターです。Transept自体のローカライズは、この設計思想全体を自社プロダクトに本格適用する初めての試みでした。ツールは持ちこたえました。上に挙げた教訓は、いまプロダクトに反映しているところです。今回の10言語対応はリハーサルであって、フィナーレではないからです。
著者
Transept共同創業者。キーウ、オストラヴァ、そしてザルツブルクでの1年間を経て、英語学・英文学の学位を3つ取得。ウクライナ出身ですが、書くのはほとんど英語です。プロンプトエンジニアとしてAIの世界に入り、その後はプロダクトマーケティングとライフサイクルマーケティングを担当。実在の人物をもとにしたセミフィクションを書きながら、言語のあいだで何がこぼれ落ちるのかという問いを追い続けています。