翻訳メモリとは?仕組みと、AIローカライズで重要になる理由
翻訳メモリには、チームが承認済みの訳文が蓄積されます。翻訳者がLLMとなった今、TMに求められる役割とは何なのか。既存のツールはどのように記憶し(あるいは忘れ)、Transeptはどのような答えを出したのか。「判断の文脈としてのメモリ」というアプローチを紐解きます。
目次
プロダクトのコンテンツ、サポート記事、各種ドキュメント、キャンペーン、ソフトウェアのテキストなどを翻訳していると、チームは常に同じ課題に直面します。
- 同じフレーズが何度も繰り返し登場するにもかかわらず、
- そのたびに翻訳、レビュー、承認に時間が取られてしまうという問題です。
翻訳メモリは、まさにこの課題を解決するために作られました。
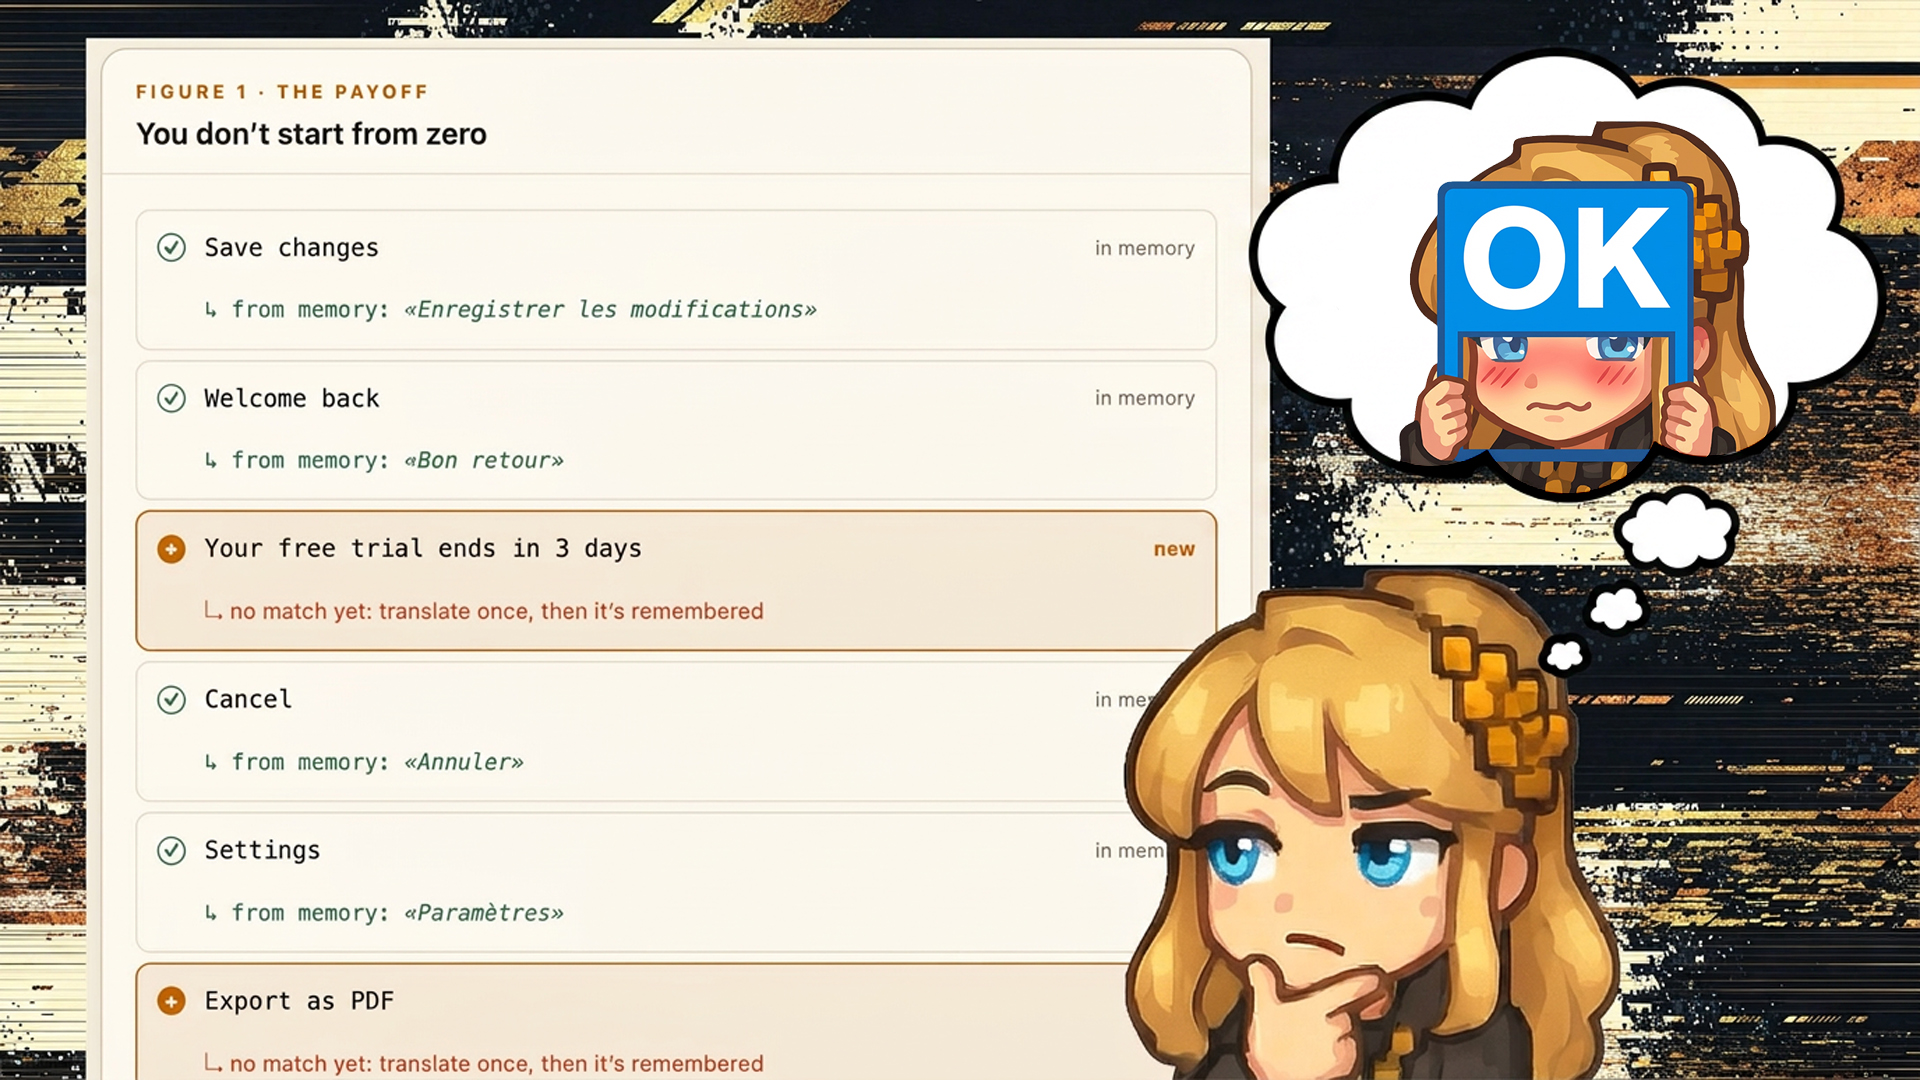
翻訳メモリ(TM)とは、チームが過去に承認した訳文を蓄積しておく仕組みです。原文と確定した訳文がペアで保存され、類似の文章が再び現れた際に、一から翻訳し直す手間を省けます。
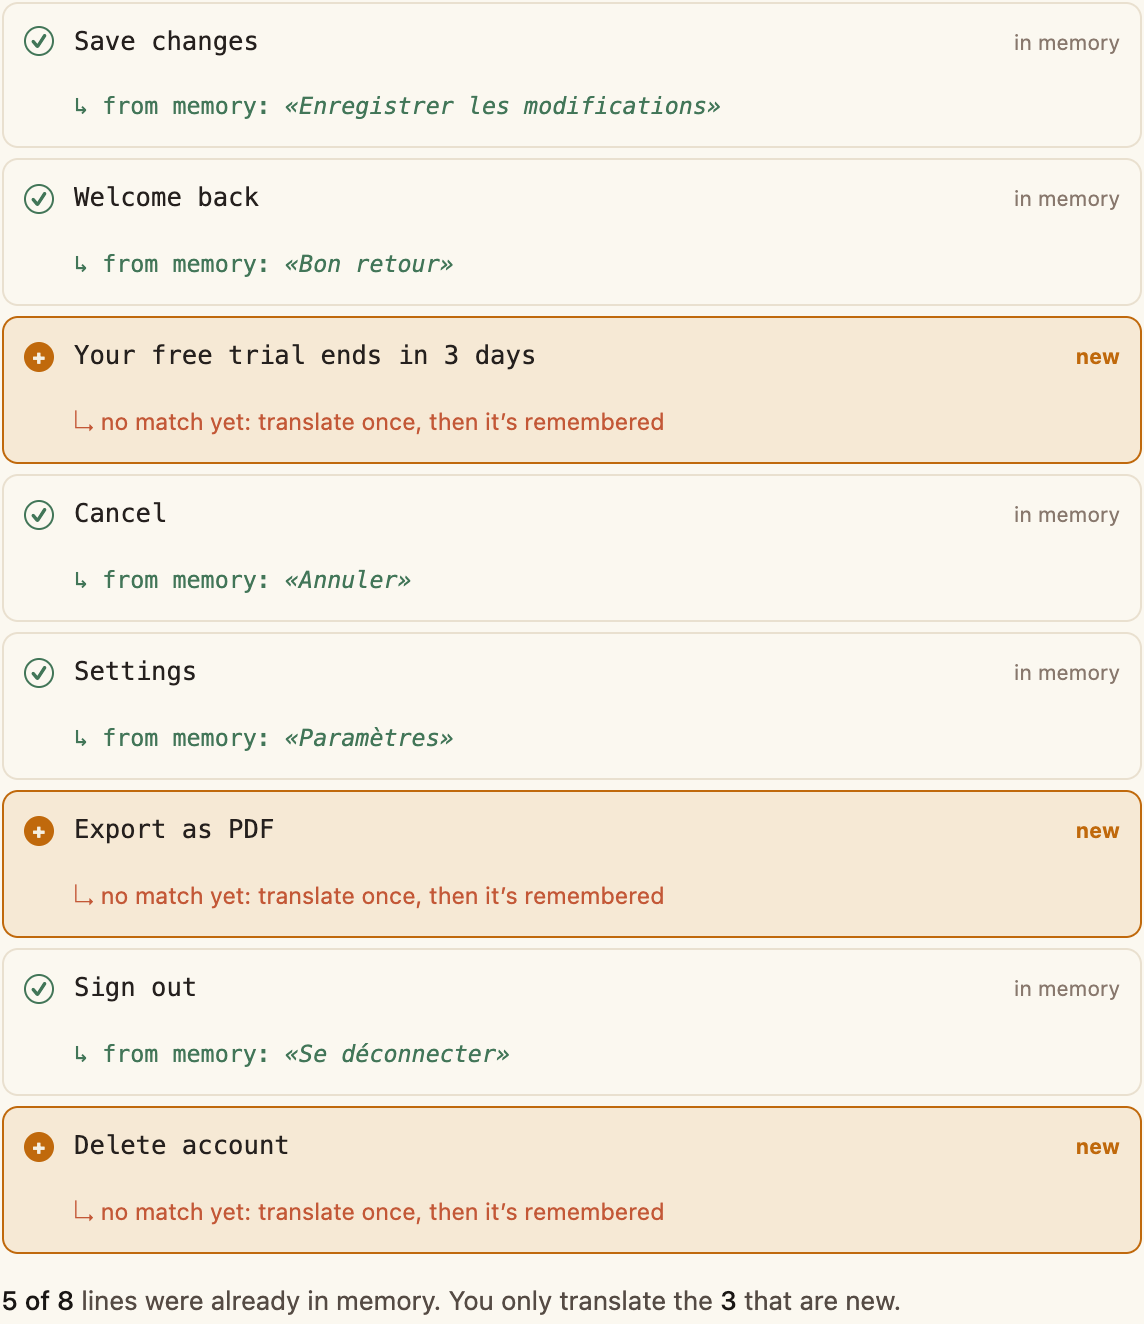
従来の翻訳ツールでは作業時間の短縮に使われてきましたが、AI翻訳ではさらに重要になります。チームの翻訳基準や、どんな判断が求められているかをモデルに示せるからです。その効果は絶大です。
- 納期の短縮(定型文や免責条項、重複するUIテキストを何度も再翻訳する必要がなくなります)
- コストの削減(理由は訳文を再利用できることだけではありません。Transeptでは、翻訳メモリの文脈を十分に与えることで、コストが4分の1のモデルを上位モデルと同等の品質まで引き上げられました)
- スタイルの統一(何年も前に承認した判断基準が、すべての新機能にそのまま継承されます)。
では、AI翻訳と組み合わせるとき、翻訳メモリはどう使えばよいのでしょうか?
- 用語集やスタイルガイドも翻訳メモリに含まれるのでしょうか? また、それらを常に最新の状態に保つにはどうすればよいのでしょうか?
- 何をもって関連性の高いセグメントと判断すべきなのでしょうか?
- AIにはどのくらいの文脈が必要なのでしょうか? どこからが少なすぎで、どこからが多すぎなのでしょうか?
- クライアントの著作物や機密情報が、ほかのクライアントに決して漏れないようにするにはどうすればよいのでしょうか?
これこそが、Transeptが突き詰めるべき課題でした。翻訳者が人間だけではなくなった今、翻訳メモリは本来どうあるべきなのか。そして、人間が低品質な訳文の山をただ処理するのではなく、翻訳メモリを活用して本質的な作業に集中できるようにするにはどうすればよいのか。
この問いから、私たちの探求が始まりました。
AI翻訳における翻訳メモリとは?
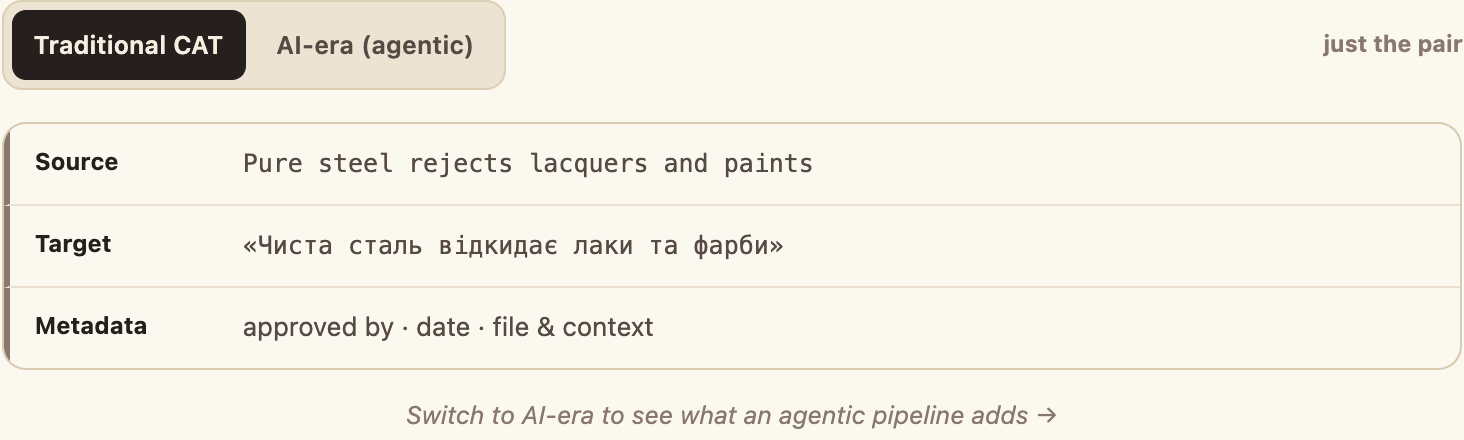
従来の定義では、翻訳メモリとは翻訳済みのテキストペアを蓄えた構造化データベースのことです。通常、各ペアには以下の要素が含まれます。
- 原文セグメント(元のテキスト)。
- 訳文セグメント(翻訳後のテキスト)。
- メタデータ(翻訳者、承認日時、前後の文脈など)。
翻訳者が新しいドキュメントを開くと、翻訳メモリソフトウェアがテキストをスキャンしてデータベースと照合し、一致するものが見つかれば過去の訳文を提案します。
これが従来のCATツールにおける定義です。しかし、LLMや自律型エージェントによる翻訳システムを導入すると、さらに多くの要素が関わってきます。
- AIが使用する専門用語を統一するために、翻訳の進行に合わせて生成される用語集。
- AIエージェント間で作業を引き継ぐ際に作成される引き継ぎノートと要約。
- 翻訳、編集、校正の過程で生成されるエージェントの思考プロセス(Thinking trace)(各判断の背景にある「理由」)。
- チャット、返信スレッド、検索履歴、Slack/Teamsのやり取りなど、エージェントと人間の間の議論の文脈。
これは人間にとっても依然として有用ですが、AIにとっては極めて重要です。人間の翻訳者がドキュメントや頭の中、あるいは会話の中で保持している文脈を、モデルが再構築できるようになるからです。皮肉なことに、LLMによる翻訳は人間「以上に」翻訳メモリやCATツールを必要としています。人間であれば、ペンと紙、そして辞書さえあれば問題なく翻訳できるのですから。
翻訳メモリにおける一致(マッチ)の仕組み
TMソフトウェアは、コンテンツをセグメントと呼ばれる小さな単位(通常は文、見出し、ボタンのラベルなど)に分割します。そのうえで一致するものを検索します。TMが一致候補をどう探すかこそが、この分野全体で最も重要な設計ポイントです。
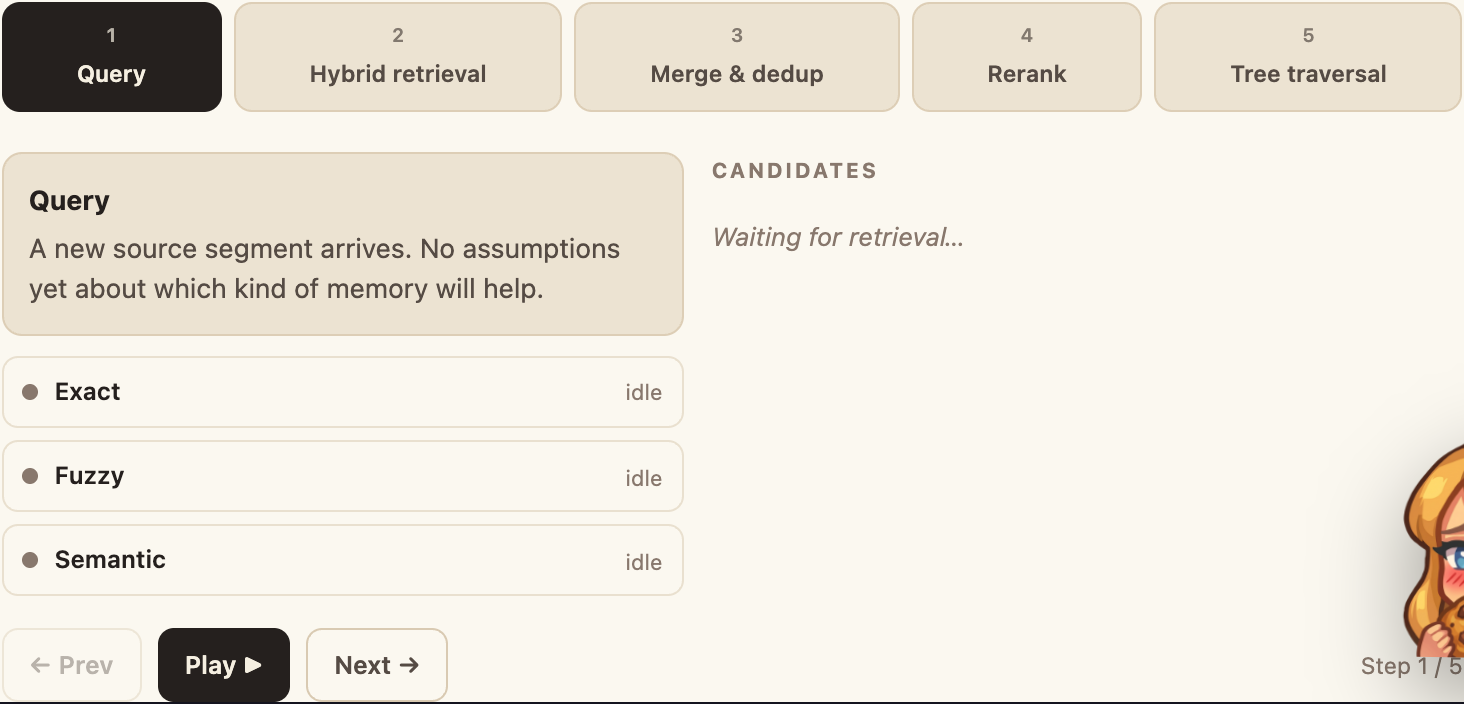
- 完全一致(Exact match):新しいセグメントがデータベース内のセグメントと100%一致している状態です。ソフトウェアが訳文を自動で入力できます。
- あいまい一致(Fuzzy match):類似しているものの、完全には一致していない状態です。人間が確認、修正、または参考として活用できるようにフラグが立てられます。通常はスパース検索(文中のすべての単語や語根を検索し、共通する要素の多さでデータベース内のセグメントをスコアリングする手法)によって実現されます。
- 意味的一致(Semantic match):単語の重複がなくても、データベース内のセグメントが類似した意味を持っている状態です。これにはデンス検索(Dense search)、つまりベクトル埋め込みによる検索が使われます。おなじみのRAGの手法です。
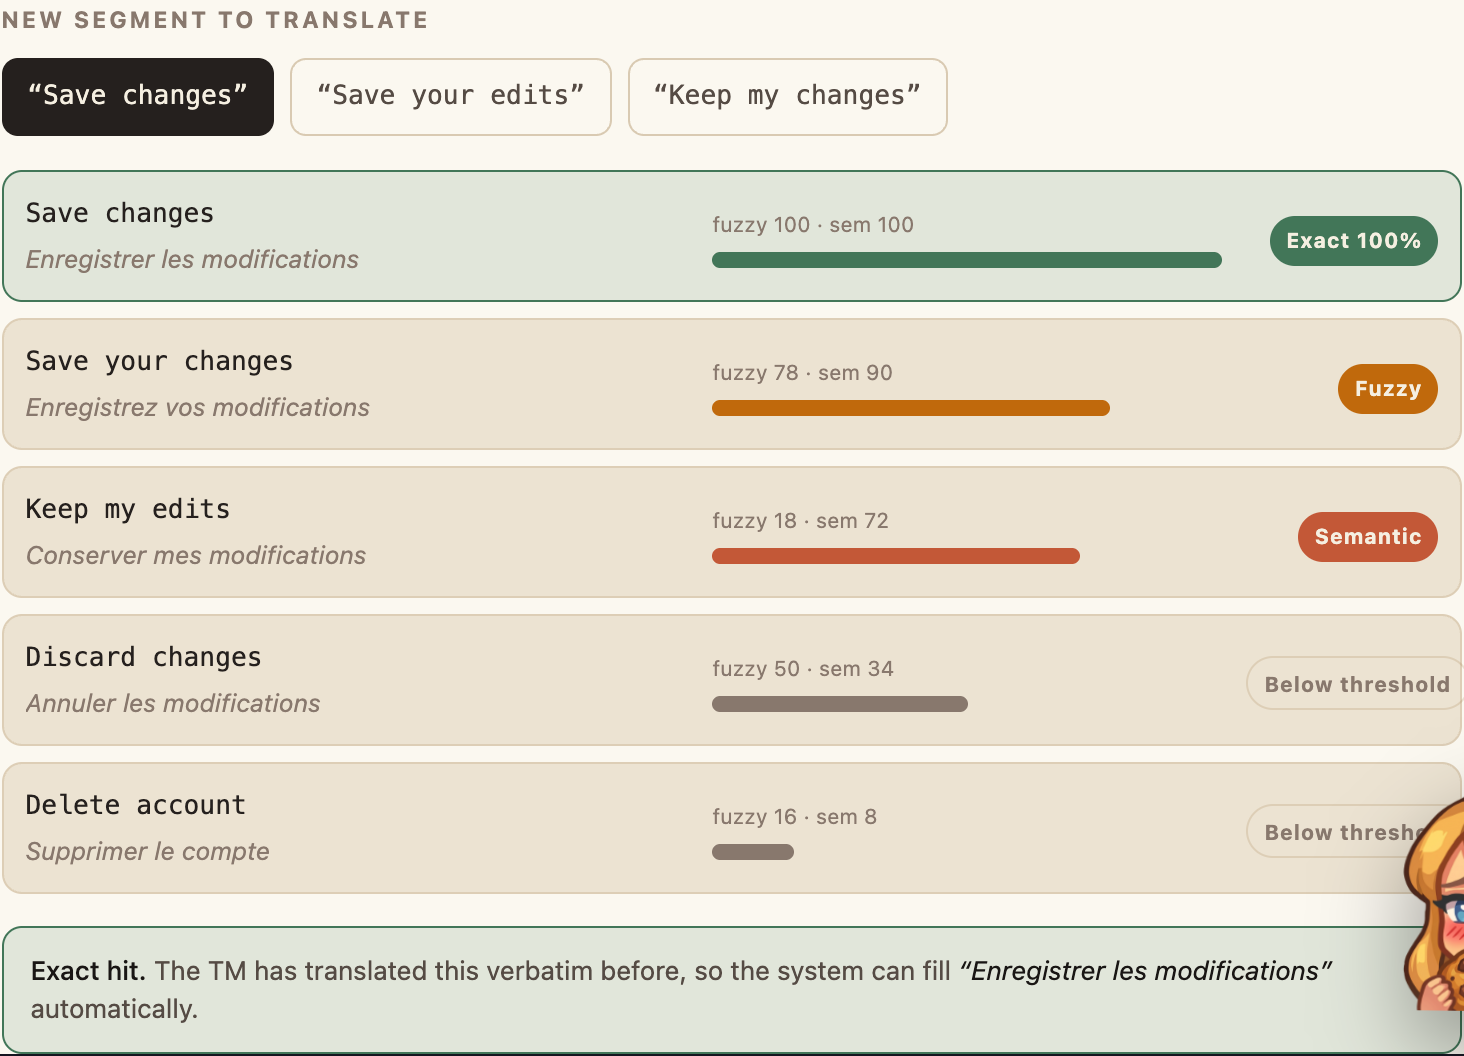
従来の翻訳メモリは完全一致やあいまい一致に依存していました。そこにLLMが登場し、意味的一致というレイヤーがもたらされました。しかし、優れたパフォーマンスを発揮するには、セマンティック検索(意味検索)だけではまだ不十分です。
文学翻訳では、固有名詞や作品世界の設定に一貫性を持たせるために、用語のあいまい一致が極めて重要になります。ヘルスケア分野では同じ内容でも多様な表現が使われるため、セマンティック検索が役立つはずですが、かえって裏目に出てしまいます。汎用エンベディングモデルにとって、ileumとiliumの距離は、crimson(深紅)とscarlet(緋色)の距離と同じくらい近いのです。
(ileumは小腸の終末部[回腸]、iliumは寛骨の上部を構成する大きな骨[腸骨]のことです。まったく無関係な用語ですが、汎用ドメインのセマンティック空間では、どちらも「医療関連」として同一視されてしまいます。)
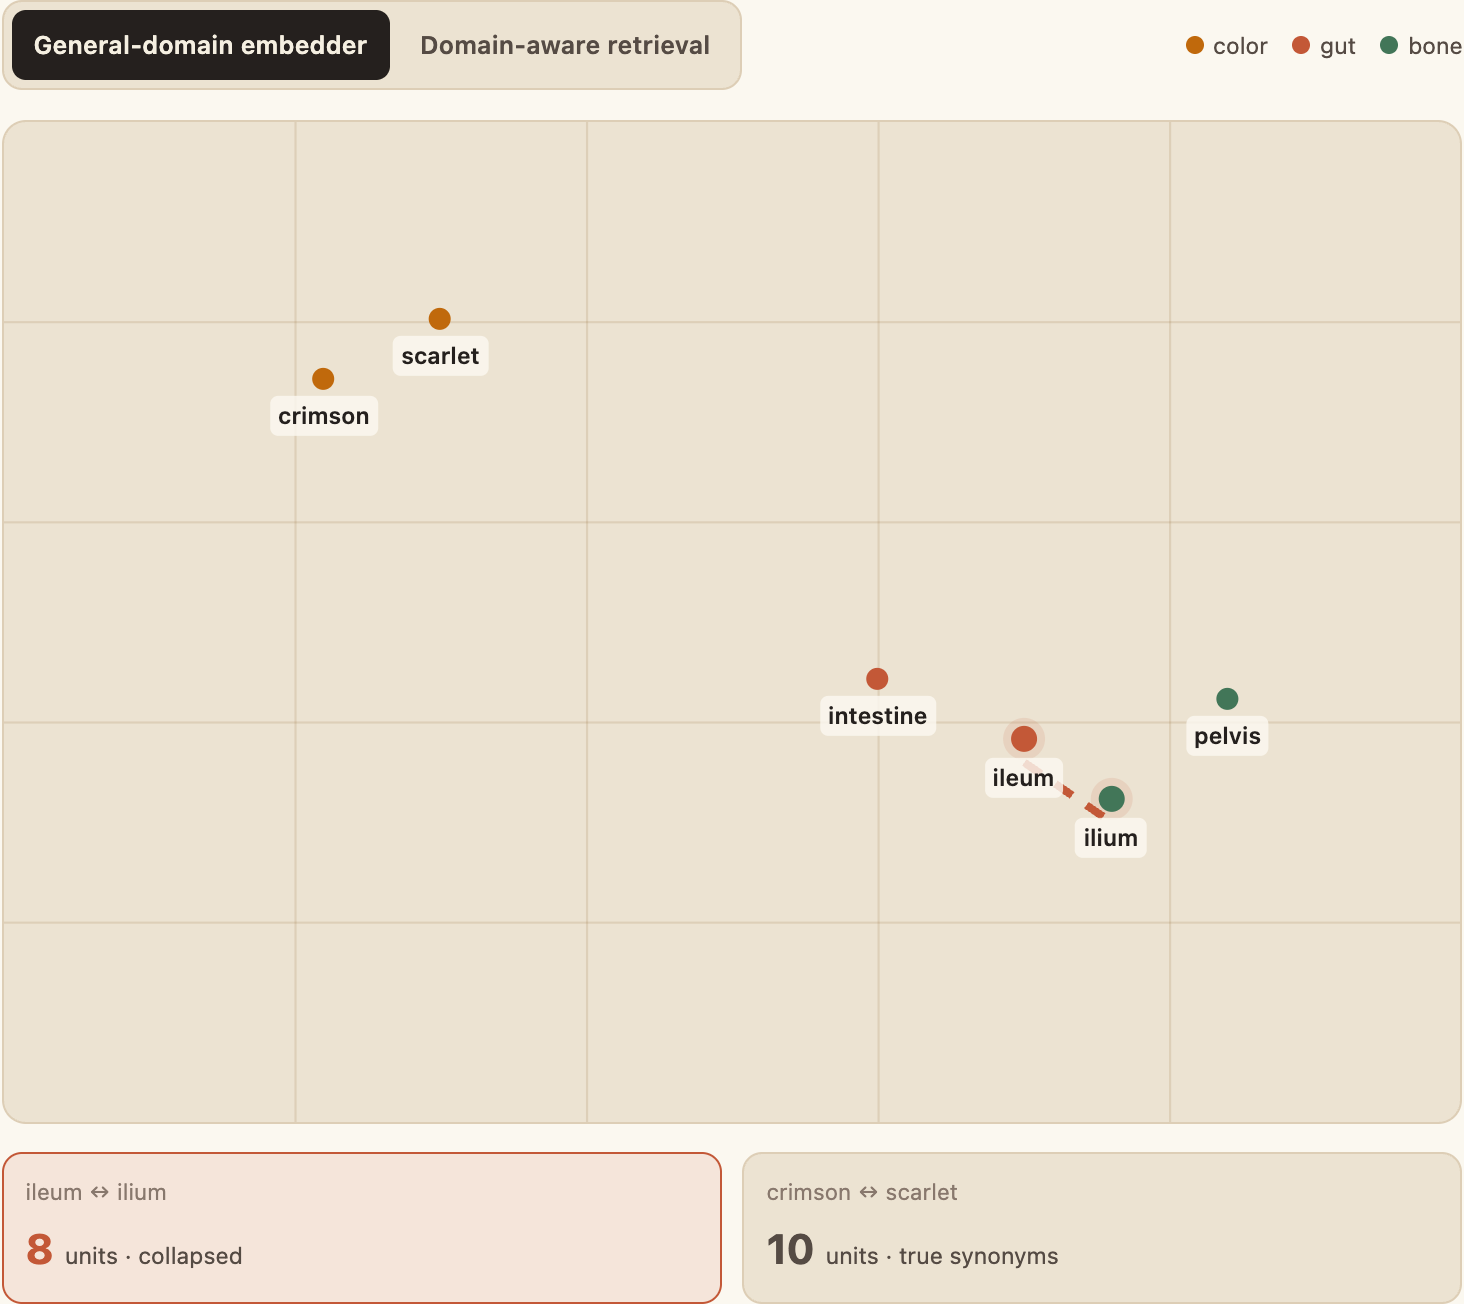
そのため、ガードレールが必要になります。2026年の翻訳メモリに標準で求められるのは、次のような仕組みです。
- ハイブリッド検索:過去の翻訳履歴から最も関連性の高い結果を導き出すために、完全一致、あいまい一致、意味的一致を組み合わせます。
- リランキング(再ランク付け):実際の文脈に照らし合わせて候補を再スコアリングし、関連性を評価します。
- ツリー探索:人間やエージェントが任意の一致から近傍へと移動し、データベース全体を探索できるようにします。
既存のツールにおける翻訳メモリのアプローチ
本格的なローカライズツールなら、どれも過去の訳文を保存し、再び提案できます。問うべきなのは、システムが「何を」記憶し、そのメモリを「いつ」信頼し、次に「どこで」使うのか、という点です。
この観点から見ると、市場は「再利用のためのメモリ」「ガバナンスのためのメモリ」「AIの糧としてのメモリ」という3つのレベルに分類されます。そしてTranseptが目指すのは第4のレベル、すなわち「判断の文脈としてのメモリ」です。
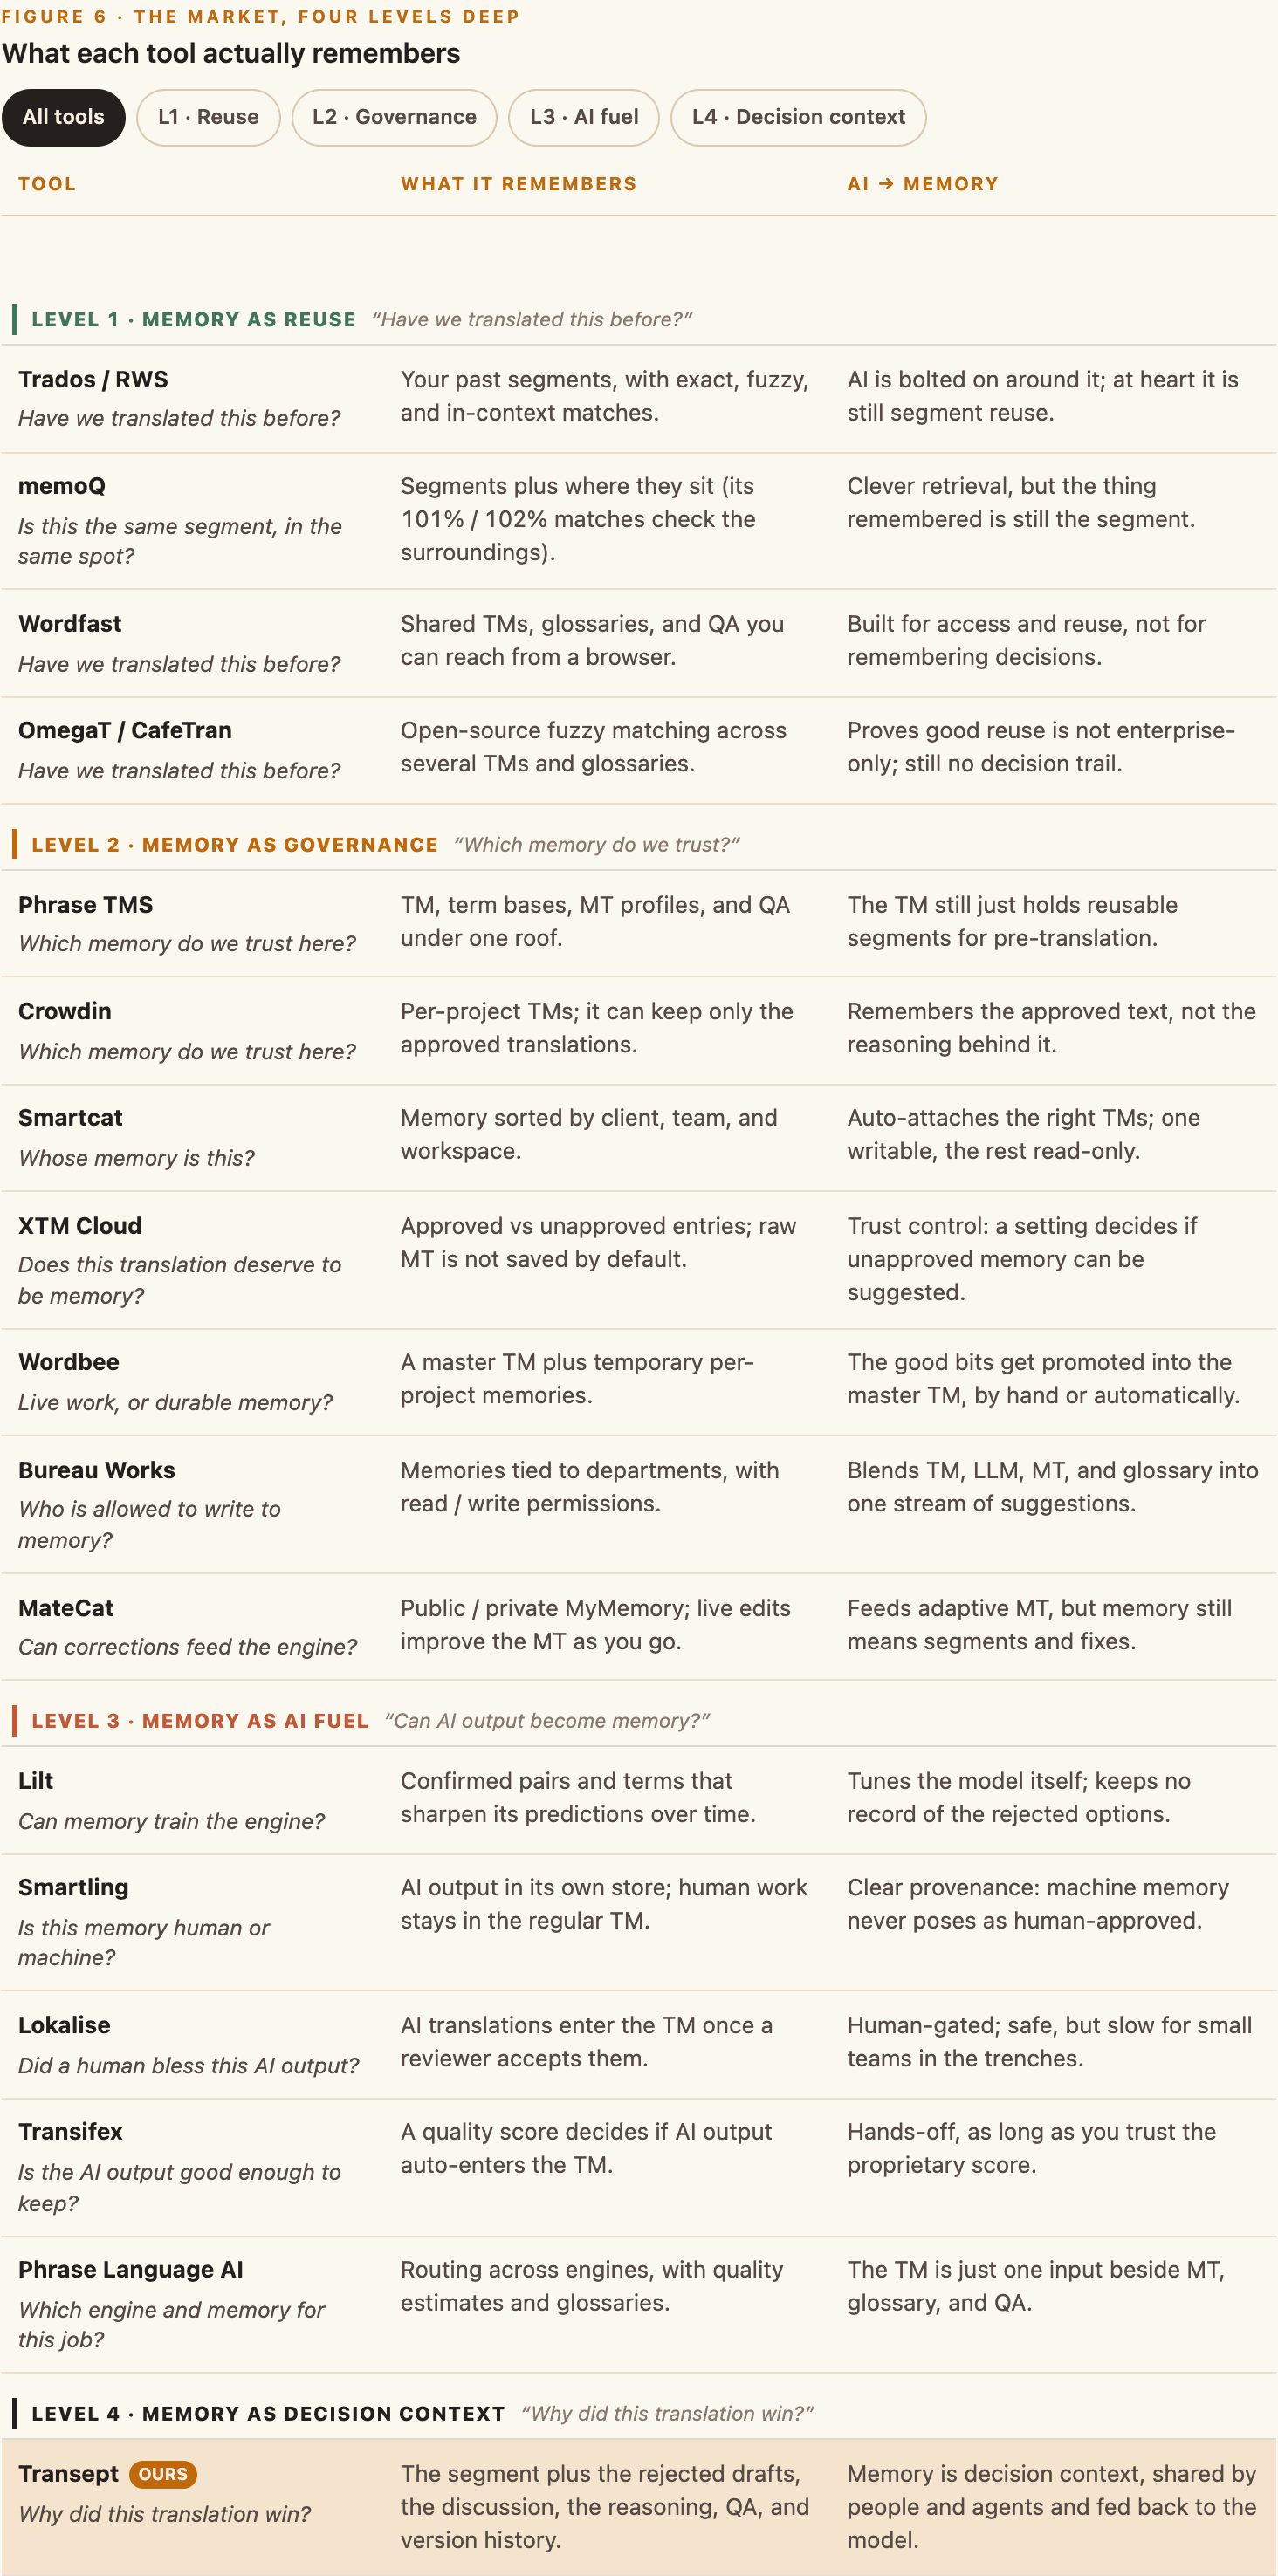
| ツール | 記憶する対象 | AI → メモリ |
|---|---|---|
レベル1 · 再利用としてのメモリ「以前にも翻訳したことがあるか?」 | ||
Trados / RWS 以前にも翻訳したことがあるか? | 過去のセグメント(完全一致、あいまい一致、コンテキスト一致を含む)。 | AIは外付けされた機能にすぎず、その本質は依然としてセグメントの再利用です。 |
memoQ 同じ箇所の同じセグメントか? | セグメントと出現位置(101% / 102%一致で前後の文脈を確認)。 | 検索は高度でも、記憶される対象は依然としてセグメントにとどまります。 |
Wordfast 以前にも翻訳したことがあるか? | ブラウザーからアクセスできる共有翻訳メモリ、用語集、QAチェック機能。 | アクセスと再利用を重視した設計であり、判断内容の記録は想定されていません。 |
OmegaT / CafeTran 以前にも翻訳したことがあるか? | 複数の翻訳メモリや用語集をまたいだ、オープンソースのあいまい一致。 | 優れた再利用性が大企業だけのものではないことを示していますが、判断の経緯は記録されません。 |
レベル2 · ガバナンスとしてのメモリ「どのメモリを信頼すべきか?」 | ||
Phrase TMS どのメモリを信頼すべきか? | 翻訳メモリ、用語集、機械翻訳プロファイル、QAチェック機能を一元管理。 | 翻訳メモリが保持するのは、依然として事前翻訳のための再利用可能なセグメントにとどまります。 |
Crowdin どのメモリを信頼すべきか? | プロジェクトごとの翻訳メモリ。承認済みの訳文のみを保持可能。 | 承認されたテキストのみを記憶し、その判断理由は残りません。 |
Smartcat 誰のメモリか? | クライアント、チーム、ワークスペースごとに整理されたメモリ。 | 適切な翻訳メモリを自動で紐付け。書き込み可能は1つのみ、残りは読み取り専用。 |
XTM Cloud この訳文をメモリとして残す価値があるか? | 承認済みエントリと未承認エントリを区別。未編集の機械翻訳はデフォルトで保存されません。 | 信頼性の制御:未承認のメモリを候補として提示するかどうかを設定で制御できます。 |
Wordbee 作業用か、恒久的なメモリか? | マスター翻訳メモリと、プロジェクトごとの一時メモリ。 | 有用な訳文は、手動または自動でマスター翻訳メモリへ昇格されます。 |
Bureau Works 誰がメモリに書き込めるか? | 部門に紐付けられたメモリ(読み取り / 書き込み権限付き)。 | 翻訳メモリ、LLM、機械翻訳、用語集を1つの候補ストリームに統合。 |
MateCat 修正内容はエンジンの学習に活かせるか? | 公開 / 非公開のMyMemory。作業中の修正がリアルタイムで機械翻訳に反映されます。 | 適応型機械翻訳に反映されますが、メモリの対象は依然としてセグメントと修正履歴にとどまります。 |
レベル3 · AIの糧としてのメモリ「AIの出力をメモリとして活用できるか?」 | ||
Lilt メモリをエンジンの学習に活かせるか? | 確定済みの対訳ペアや用語により、時間の経過とともに予測精度を向上。 | モデル自体をファインチューニングするものの、却下された選択肢の記録は残りません。 |
Smartling このメモリは人間によるものか、機械によるものか? | AIの出力は専用ストアに保存され、人手による訳文は通常の翻訳メモリに保持されます。 | 明確な出所管理:機械によるメモリが人間によって承認されたものとして扱われることはありません。 |
Lokalise このAI出力は人間による承認済みか? | レビュアーが承認した時点で、AI翻訳が翻訳メモリに登録されます。 | 人手による承認が前提。安全ですが、現場で作業にあたる少人数のチームにとっては進行が遅くなります。 |
Transifex このAI出力は保持するに値する品質か? | 品質スコアに基づき、AI出力を翻訳メモリへ自動登録するかどうかを判定。 | 独自の品質スコアを信頼できる限り、手間はかかりません。 |
Phrase Language AI このジョブにはどのエンジンとメモリを使うべきか? | 品質予測や用語集を活用した、複数エンジン間のルーティング。 | 翻訳メモリは、機械翻訳、用語集、QAチェック機能と並ぶ入力情報の1つにすぎません。 |
レベル4 · 判断の文脈としてのメモリ「なぜこの訳文が選ばれたのか?」 | ||
Transept当社 なぜこの訳文が選ばれたのか? | セグメントに加え、不採用となった下書き、議論、判断理由、QA、バージョン履歴を保持。 | メモリとは判断の文脈であり、人間とエージェントの間で共有され、モデルへとフィードバックされます。 |
レベル1:再利用のためのメモリ
従来のCATツールが答えるのは、翻訳メモリで最も古い問い、「以前にもこれを翻訳したことはあるか?」です。
決して原始的なツールというわけではありません。多くは文脈を考慮した一致、フラグメント検索、機械翻訳プラグイン、チームサーバー、高度なエディターワークフローに対応しています。しかし、翻訳メモリは主にエディターの横で候補を提示するソースとして置かれているにすぎません。過去の成果を再利用する役には立ちますが、ある訳が別の訳より選ばれた「理由」までは、通常は記憶していません。
- Trados / RWSは、従来のCATツールにおける基準となる存在です。完全一致、あいまい一致、コンコーダンス、コンテキスト内完全一致(ICE)に強みを持ち、Tradosのエコシステム全体としては現在、AIやLanguage Weaverのワークフローも取り入れています。しかし翻訳メモリのレベルで見ると、その中核にある考え方は依然としてCAT環境におけるセグメントの再利用に留まります。
- memoQは、文脈の扱いという点で、従来の翻訳メモリを特に大きく前進させています。101%一致や102%一致は、同じセグメントが同じ「場所」に現れているかどうかを判定しようとするもので、ソフトウェアの文字列や繰り返し出てくるラベル、構造化ファイルで重要になります。賢い検索ですが、記憶する対象はあくまで「文脈の中のセグメント」です。
- Wordfastは、翻訳メモリのポータビリティと実用性を重視しています。Wordfast Anywhereを使えば、ブラウザーベースの共有翻訳メモリ、用語集、品質チェック(QA)、機械翻訳を利用できます。その真価は手軽さと再利用性にあり、判断の経緯まで掘り下げて記憶することではありません。
- OmegaTやCafeTranは、本格的な再利用が大企業向けツールだけのものではないことを示しています。無料のオープンソースでありながら、あいまい一致、一致の反映、複数の翻訳メモリ、用語集のサポートを備え、パワーユーザー向けのチーム用翻訳メモリサーバーも用意されています。
このように、基本水準はすでに高いところにあります。低価格のツールや独立系ツールであっても、翻訳を記憶して再利用する機能は十分に優れています。商用ツールの競争は、再利用の「その先」で何が起きるかから始まるのです。
レベル2:ガバナンスのためのメモリ
次のグループが投げかけるのは、別の問いです。「このクライアント、チーム、プロジェクト、ワークフローでは、どのメモリを信頼すべきか?」
- Phrase TMSは、メモリをより大きなプラットフォーム内で管理されるリソースの1つとして扱います。翻訳メモリ、用語ベース、機械翻訳エンジンのプロファイル、Phrase Language AI、品質スコアリング、品質チェック(QA)などが統合されています。カバー範囲は広いものの、翻訳メモリ自体が保存する対象は依然として再利用可能なセグメントが中心です。
- Crowdinは、プロジェクト規模でメモリを活用しやすくしています。プロジェクトごとの翻訳メモリの自動生成、承認済み訳文のみを保存する設定、単純な100%一致とPerfect match(テキストと文脈の両方が一致)の区別などを備えています。文字列を事前に入力してくれますが、記憶されるのはあくまで承認済みのテキストであり、判断の経緯ではありません。
- Smartcatは、クライアント、部署、ワークスペース、AI翻訳プロファイルといった関係性を軸にメモリを整理します。関連するメモリや用語集を自動的に紐付け、1つの書き込み可能な翻訳メモリと複数の読み取り専用メモリを組み合わせます。その強みはルーティングと権限管理にあります。
- XTM Cloudは、メモリをステータス管理と保護が必要な対象として扱います。エントリには承認ステータスを付与でき、未編集の機械翻訳が自動保存されることはありません。変更履歴のあるセグメントは承認または却下されるまで保留され、未承認のメモリを候補として提示するかどうかも設定で制御できます。主眼は信頼性の制御にあります。
- Wordbeeは、恒久的な翻訳メモリと一時的なプロジェクトメモリを区別します。プロジェクトメモリは進行中の作業を記録し、作業の途中でもセグメントを候補として提示できます。その後、有用な部分がマスター翻訳メモリへと統合されます。リアルタイムのドキュメントコンテキストに近いアプローチですが、本質は依然としてセグメントの保管庫です。
- Bureau Worksは徹底した管理に重点を置いています。部門ごとにメモリを紐付け、読み取り/書き込み権限を細かく設定し(一般の翻訳者は利用のみ、追加できるのはロケールリードのみ)、翻訳メモリ、LLM、従来の機械翻訳、用語集を融合した単一の推奨ストリームを提供します。強力である反面、情報過多になることもあり、最終的な判断は依然として候補を読む人間の手に委ねられています。
- MateCatは、翻訳メモリにMyMemory、機械翻訳にModernMTを連携させたWebベースのCATエディターです。パブリックおよびプライベートのメモリが機械翻訳の候補に反映され、作業中に修正を加えることで出力精度がリアルタイムに向上します。これは単に機械翻訳の横に翻訳メモリを並べるよりも、「適応型機械翻訳を支援する翻訳メモリ」に近い形です。それでもなお、ここでのメモリが意味するものはセグメント、一致、修正履歴に留まります。
レベル3:AIの糧としてのメモリ
最新のグループが投げかけるのは、AIが翻訳を「生成」し、「編集」し、あるいは翻訳から「学習」するときに何が起きるかという問いです。機械の出力はメモリになり得るのか? 事前のレビューは必要なのか? 品質のスコアが人の承認の代わりになるのか? 翻訳メモリでエンジンそのものを誘導できるのか?
- Liltは、翻訳メモリを適応型機械翻訳の糧として扱います。確定された対訳ユニットと用語集データによって、予測候補の精度が時間の経過とともに向上します。主眼はエンジン内部での適応型予測にあり、コメントや却下された候補、レビュー時の判断理由といった、より広範な記憶ではありません。
- Smartlingは出所を明確に区別します。AIの出力は「機械生成翻訳メモリ」という独立したメモリに保存でき、人の手による訳文や人によって検証された訳文は通常の翻訳メモリに残ります。AIの出力を再利用可能にしつつも、人の承認を経たものとして紛れ込ませることは決してない、堅牢な信頼モデルです。
- Lokaliseはレビューを信頼性の関門として活用します。レビュアーがレビュータスクで承認すれば、テキスト自体を編集しなくても、AIや機械翻訳による訳文を翻訳メモリに登録できます。AIの出力も恒久的なメモリとして残せますが、必ず人の手を経る必要があるため手間が生じます。現場で判断が下され、それを即座に記録したい小規模チームにとっては理想的とは言えません。
- Transifexは、自動化の関門としてTQI(翻訳品質指標)を活用しています。通常、生成された訳文はレビューなしで翻訳メモリに登録されることはありませんが、Transifex AIが独自のTranslation Quality Indexで訳文を評価し、設定したしきい値を超えた場合には自動で登録できます。難点は、その独自の指標を信頼しなければならない点です。
- Phrase Language AIはオーケストレーション層としての役割を果たします。エンジンやエージェント型ワークフロー全体への作業のルーティング、品質推定の活用、用語集の適用、機械翻訳プロファイルの管理、独自エンジンの持ち込みへの対応などを備えています。システム設計としては強力ですが、翻訳メモリは機械翻訳、用語集、品質チェック(QA)、ルーティングと並ぶ入力のひとつにとどまります。
市場で見出したギャップ
こうして見ると、市場は最終的な訳文の保存、人間と機械の出力の区別、適切なメモリへのルーティング、そしてAIの出力を再利用してよいタイミングの判断において、着実に進歩しています。私たちはこれらすべてを、備えていて当然の前提と考えました。
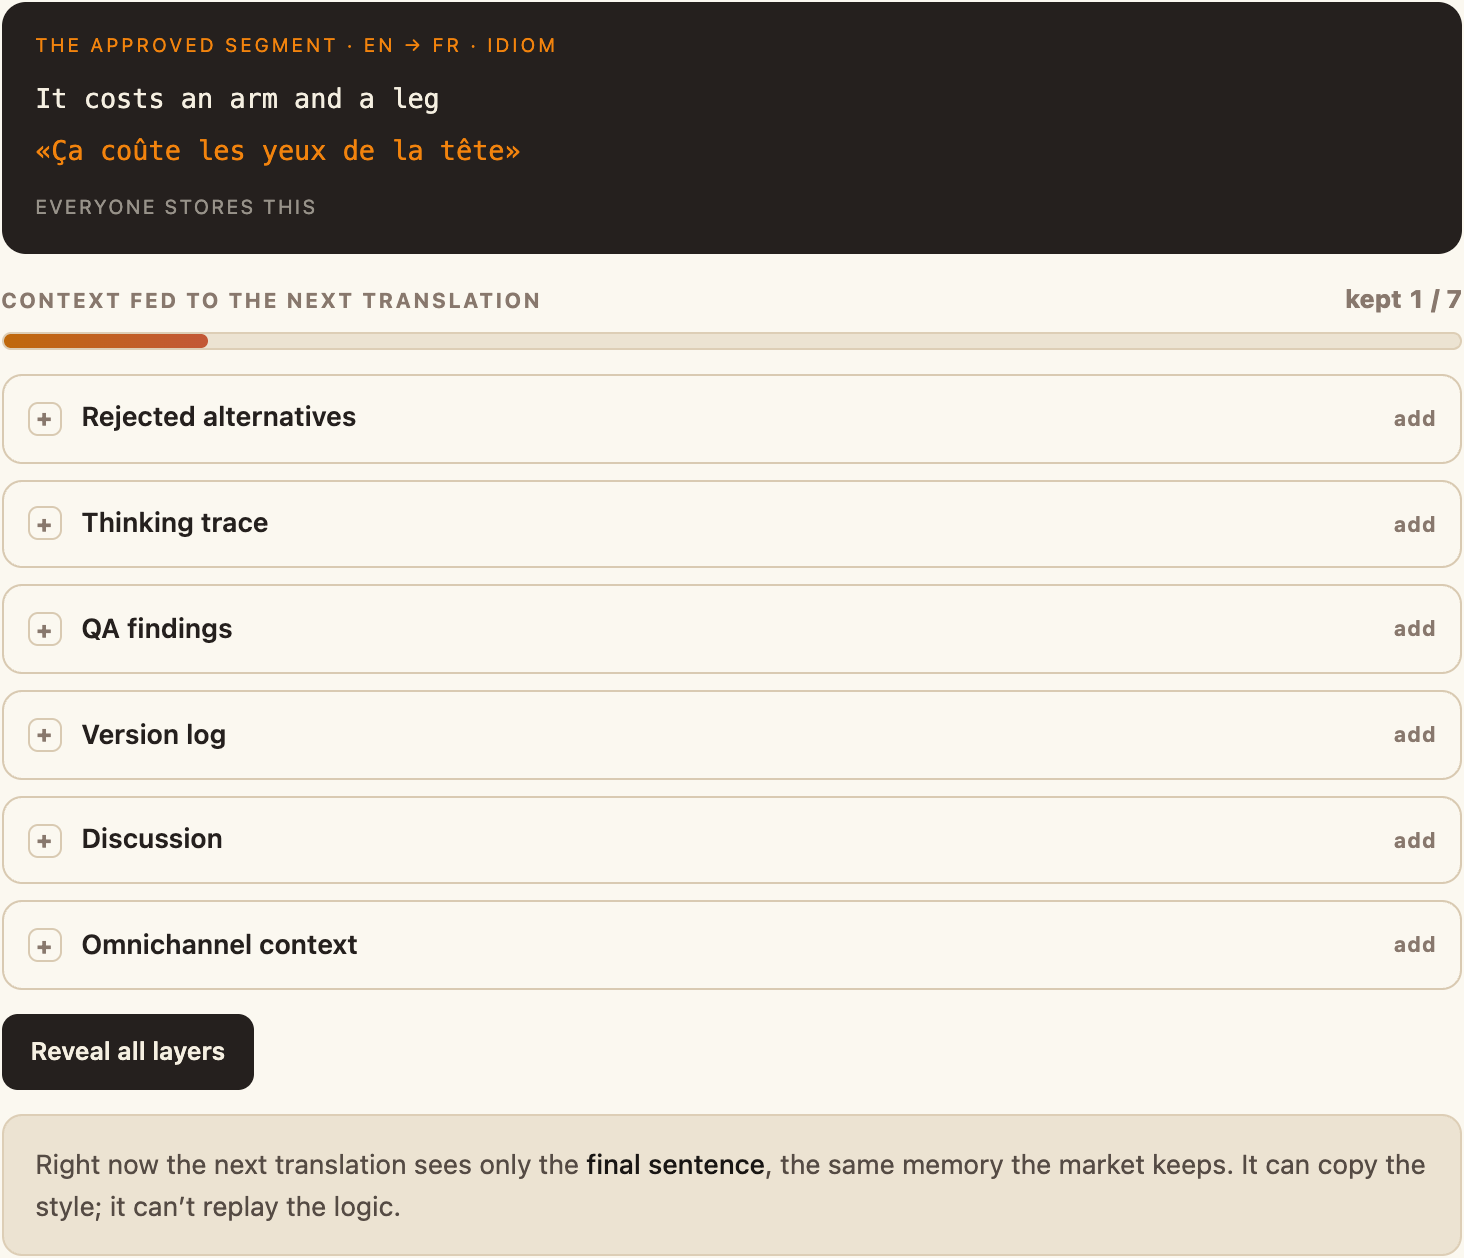
今もまだ珍しいのが、翻訳の「周辺の作業」の記憶です。却下された候補、コメント、レビュー履歴、検索コンテキスト、承認のロジック、そしてある訳が選ばれた理由を説明する意思決定の道筋を記録するツールはほとんどありません。翻訳プロセスは自然とこうした貴重な副産物を生み出しているにもかかわらず、それを掘り起こそうとする人はほぼ皆無でした。
さらに珍しいのが、その履歴を高機能なLLMへフィードバックし、次の翻訳で最終的な出力だけでなく「判断の理由」まで再利用できるようにすることです。
それこそがTranseptの賭けでした。文がどれほど重要でも、翻訳メモリは文を記憶するだけでは足りません。その文を信頼できるものにした作業まで記憶すべきです。TMは、人とAIが等しく共有する判断の文脈にならなければなりません。
Transeptにおける翻訳メモリの実装方法
Transeptが目指すのは、LLMで到達できる翻訳品質の最先端を築くことです。
私たちが資金もない個人の著者や翻訳者だった頃、AIは手の届く唯一の手段でした。LLMは人間の関与なしには真価を発揮できません。しかし、人の関与とはこの世で最も貴重な資源、すなわち誰かの人生の時間そのものです。だからこそ私たちは、メモリを受動的なデータベースとして扱うのではなく、ワークフローに能動的に参加するものとして構築しました。メモリは常に情報を吸収し、常に価値を還元します。
ハイブリッド検索と詳細なフィルタリング
Transeptの翻訳メモリは、あいまい検索とベクトル検索を組み合わせたハイブリッド検索で動作し、高速かつ高精度です。ただし、検索は仕事の半分にすぎません。残りの半分は、「何を」取り出すかを制御することです。
メモリに取り込む対象は厳密にフィルタリングできます。組織全体のライブラリから取得することも、特定のチームのポートフォリオに絞り込むことも、単一のプロジェクトに限定することもできます。デフォルトではTMSステータスを用いて手動で承認されたドキュメントのみが含まれますが、チーム、ドキュメント、プロジェクト単位で上書き設定できます。
人間とAIエージェントの双方が、最も関連性の高い過去の訳文を確認できます。これには却下された候補や、最終決定の背景にある議論も含まれます。何が選ばれたかだけでなく、「なぜ」選ばれたのかまで把握できます。
段階的な翻訳メモリグラウンディング
AIによる自動フローでLLMがより良い結果を出せるよう、私たちが「段階的な翻訳メモリグラウンディング」と呼ぶ仕組みを開発しました。
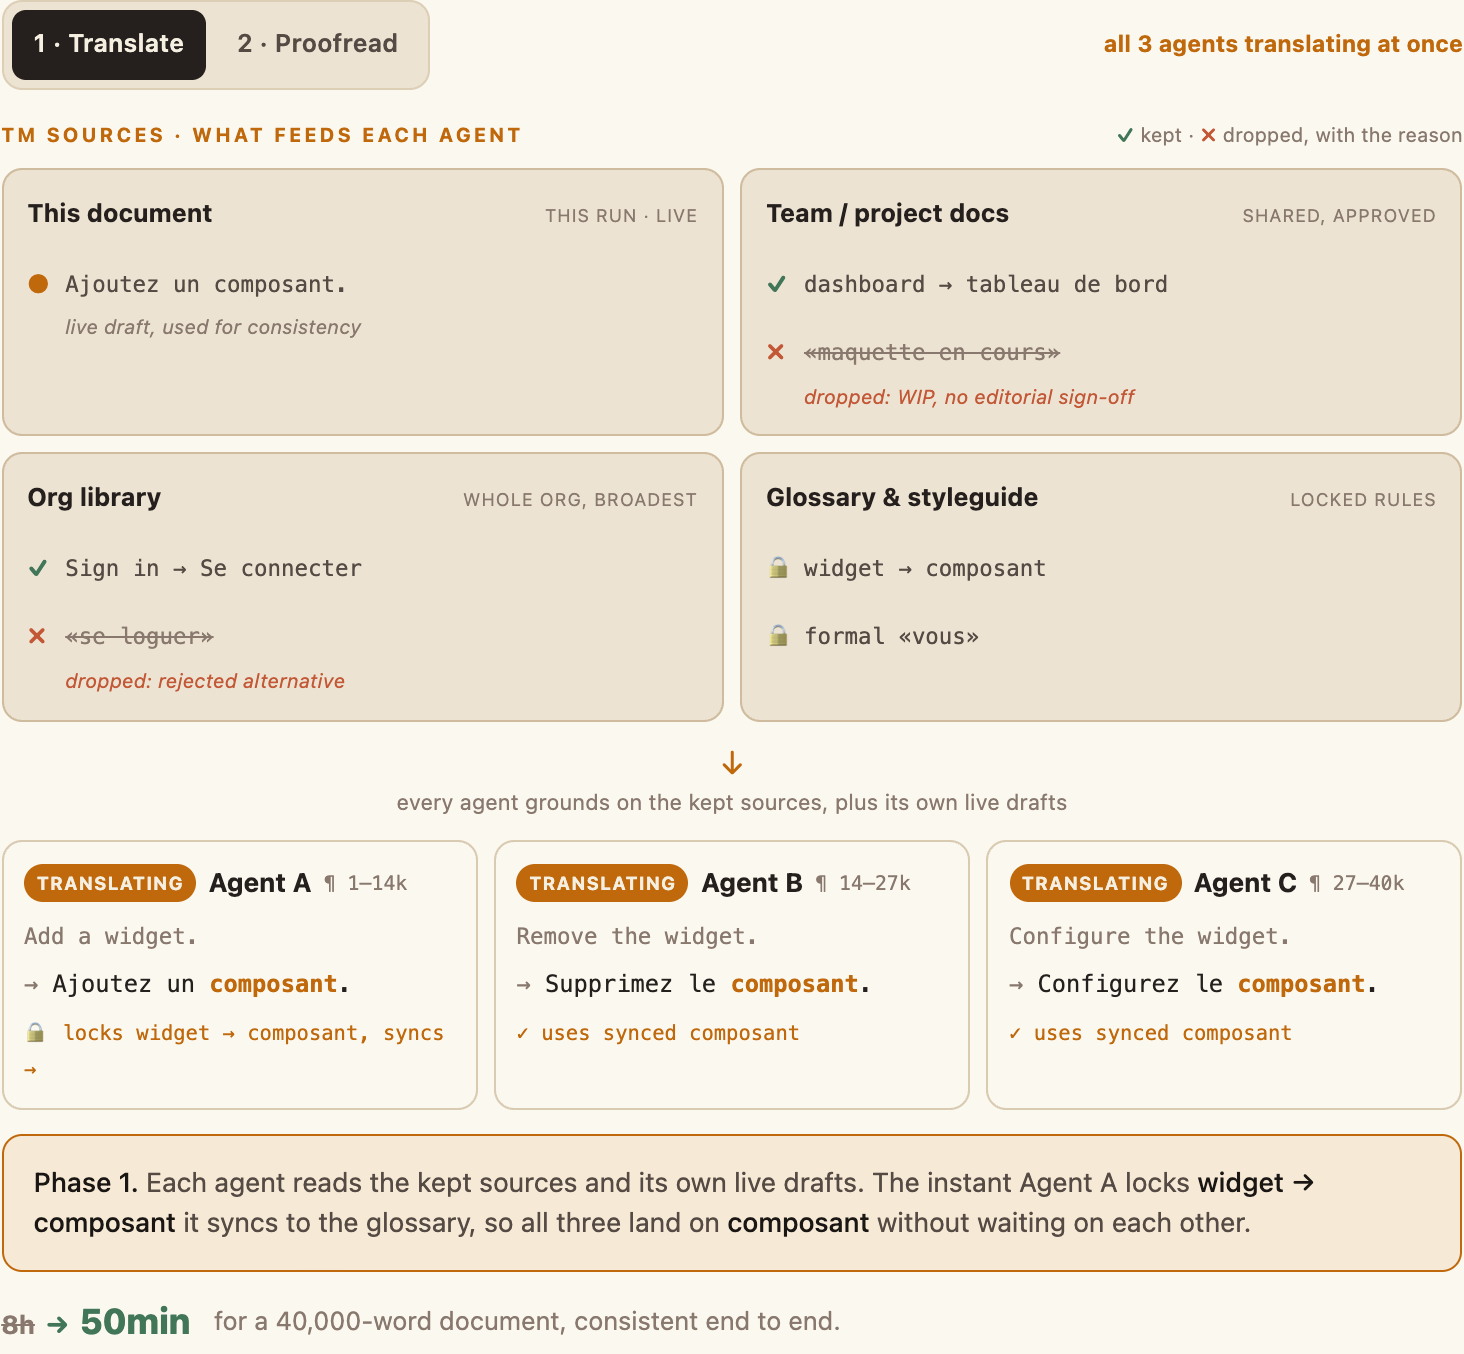
- リアルタイムのドキュメント同期:AIは翻訳中、承認済みの翻訳メモリだけでなく同一ドキュメント内の先行セグメントも読み込みます。これにより、厳密な用語集やスタイルガイドがなくても、用語、スタイル、表現の選択における一貫性が保たれます。
- 安全な校正:AIがテキストを「校正または改善」する際、同一ドキュメント内のセグメントはAIエディターによって承認済みと判定された後にのみ文脈として使用されます。これにより、モデルによるハルシネーションや、過去のエラーの再発を防ぎます。
- 並列エージェント同期:特大サイズのドキュメントを複数のエージェントで同時翻訳する場合、エージェント間でメモリが常時同期され、ドキュメント全体へ判断が反映されます。これは極めて高い技術的ハードルでしたが、4万語のドキュメントの翻訳時間を8時間から50分に短縮できました。
拡張された文脈とワークフローの制御
優れた判断と人間の知見を捉える仕組みを整えた私たちは、さらに踏み込んで、より深い文脈の把握とワークフローの利便性向上を追求しました。
- オムニチャネルな文脈:チャット、コメント、ドキュメント検索により、人間もAIも翻訳の背景にある文脈を把握できます。Web検索、辞書検索、エディター内のコメント、チームメイトやLiteressとの議論などがこれに含まれます。
- 柔軟に調整できるワークフロー:Transeptの自動ワークフローでは、翻訳メモリを使ってドキュメントを改善することもできます。デフォルトの動作を強制するのではなく、各ステップにおけるメモリの動作をチームごとに細かく調整できるようにしています。
- バージョンの候補履歴:翻訳バージョンのログにより、AIや人間の手による多数の下書きの中からどれが選ばれたかをチームで記録できます。これにより、翻訳メモリは文体だけでなく、翻訳の「ロジック」までも再現できるようになります。
- レビュー機能におけるLiteress:Literessは、メモリをレビュー作業に直接反映させます。用語集、スタイルガイド、ドキュメントの文脈、先行セグメント、品質チェックの検出結果、翻訳履歴を活用して、ドキュメントへのコメント、問題点の説明、修正案の提示を行い、人間のレビュアーが最終決定を下せるようサポートします。
人間とAIで機能を同等に
Transeptの理念の中核にあるのが、人間とAIで機能を同等にすることです。翻訳者のワークフローは多種多様だからこそ、あらゆるツール、メモリ層、コンテキストウィンドウを、人間の専門家とAIエージェントの双方が等しく利用できるようにしています。
その結果、メモリ層が作業に能動的に参加する環境が生まれます。人間が過去のファイルを1つずつ確認してある単語の訳し方を調べる代わりに、システムが下書きの作成中にその文脈をAIへと渡し、品質チェック時にはエラーの検出に活用し、人間のレビュアーにも提示します。
チームは単調な一貫性の管理から解放され、何が「しっくりくるか」を判断する仕事に戻れます。AIが抜け漏れを防ぎ、Transeptはその過程で下された創作上・法務上の判断をすべて記録します。
著者
Transept共同創業者。ペンネーム「Mevkh」名義で執筆。言語学・文学の学位を取得後、ソフトウェア開発へと転向。シニアAIエンジニアとして、RAG、エージェント型ツール、LLM-as-judgeによる評価など、実用的なLLM機能を50,000人以上のユーザーに提供してきました。小説家としてはじっくり創作を進めるタイプで、机の引き出しには12万語に及ぶ風刺ロマンスファンタジーが眠っています。AI翻訳と自身の書いた散文との間で生じた摩擦こそが、すべての始まりでした。