Ich habe meinen Roman mit ChatGPT, Claude, Gemini und Google Translate übersetzt. So ist es gelaufen
Wir haben neun Kapitel meines Romans – 15.000 Wörter – mit Google Translate, ChatGPT, Claude, Gemini und Transept aus dem Englischen ins Ukrainische übersetzt und dann gezählt: jeden Namen, dessen Schreibweise sich änderte, jede ausgelassene Zeile und jeden Freund, der plötzlich ins Siezen verfiel. In einer einzigen langen Unterhaltung hielten die Chatbots die Namen einheitlich, in neuen Chats gerieten sie durcheinander.
Auf dieser Seite
Ich schreibe einen Roman über Erasmus-Studierende in Ostrava. Darin gibt es eine ukrainische Heldin, einen flirtfreudigen Spanier, türkische Mitbewohner, einen Wohnheim-Gruppenchat, der niemals schläft, und jede Menge Bier. In Kapitel 7 erzählt Sofia ihrem Freund Aybars von Claude, und er fragt: „Who tf is Claude?“ Sie erklärt: „Like ChatGPT but different. Better. Smarter…“
Als wir also herausfinden wollten, welches KI-Tool einen Roman konsistent hält, wusste ich sofort, welches Buch ich nehmen würde. Bei diesem Test mussten ChatGPT und Claude einen Satz übersetzen, der eine klare Rangfolge zwischen ihnen festlegt. (Beide haben ihn getreu übersetzt. Verteidigt hat sich keiner.)
Was haben wir getestet?
Wir haben die ersten neun Kapitel meines Romans aus dem Englischen ins Ukrainische übersetzt, und zwar mit allen Tools, zu denen Autoren wohl als Erstes greifen. Dann haben wir gezählt, was sich von Kapitel zu Kapitel veränderte.
| Was | Wie |
|---|---|
| Ausgangstext | Kapitel 1–9 meines noch unfertigen Romans: 14.919 Wörter, 737 Absätze, 25 namentlich genannte Personen und Orte |
| Sprachrichtung | Englisch → Ukrainisch |
| Google Translate | Der kostenlose Tab „Dokumente“ – der gesamte Auszug als eine einzige Word-Datei |
| ChatGPT, Claude, Gemini | Die Modelle der jeweiligen Gratis-Tarife, Stand Oktober 2026: GPT-6 Luna, Claude Sonnet 5.5 und Gemini 3.8 Flash, jeweils über die API des Anbieters |
| Transept | Der Workflow „Novel or book“ (Übersetzen, Korrekturlesen am Ausgangstext, Namensprüfung) im Modus „Standard“, der auf Claude Opus 5.5 läuft, mit einem Glossar derselben 25 Namen |
| Zeitraum | 19.–20. Oktober 2026 |
Jeden Chatbot haben wir auf drei Arten getestet, weil Autoren sie auf drei Arten nutzen:
- Eine lange Unterhaltung: „Ich schicke dir meinen Roman Kapitel für Kapitel“, danach jedes Kapitel im selben Chat.
- Ein neuer Chat für jedes Kapitel – so läuft es, wenn eine Unterhaltung zu lang wird und man eine neue beginnt.
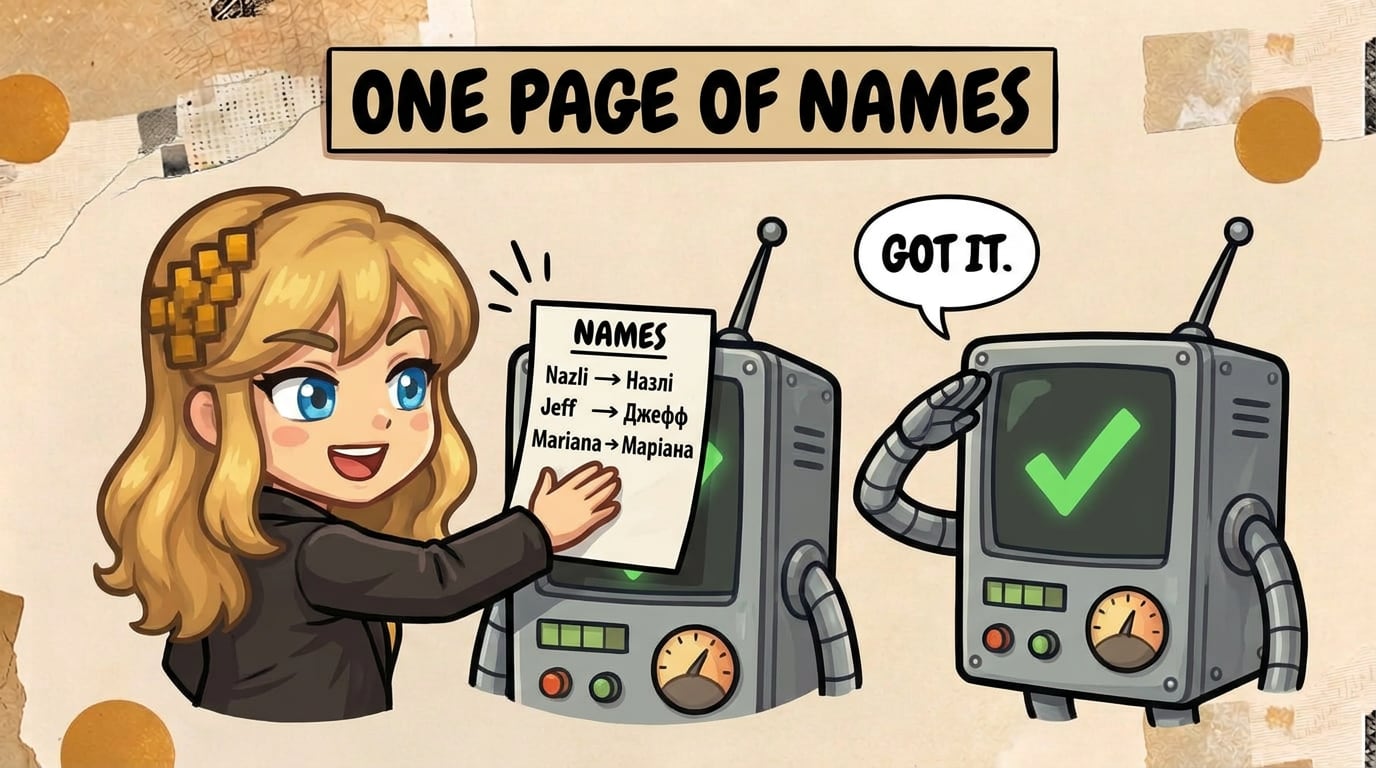
- Ein neuer Chat für jedes Kapitel, mit eingefügter Namensliste: „Verwende diese ukrainischen Schreibweisen: Nazli → Назлі, Jeff → Джефф…“
Jeder Durchlauf bekam dieselbe kurze Anweisung: das Kapitel vollständig übersetzen und dabei Ton, Witze, Slang und Formatierung beibehalten.
Warum ausgerechnet Ukrainisch?
Weil sich Fehler im Ukrainischen zählen lassen. Namen werden dekliniert (Софія, Софії, Софією), daher lässt sich leicht unterscheiden, ob eine Übersetzung dieselbe Person unterschiedlich schreibt oder den Namen bloß korrekt beugt. Außerdem muss sich im Ukrainischen jeder Sprecher zwischen dem informellen „ти“ und dem formellen „ви“ entscheiden. Freunde, die in Kapitel 2 „ти“ und in Kapitel 6 „ви“ sagen, sind ein Ausrutscher, den ein Muttersprachler sofort spürt – und den ein Skript finden kann.
Wie haben wir gezählt?
In jeder Version haben wir drei Dinge gezählt:
- Namen mit wechselnder Schreibweise über alle neun Kapitel hinweg. Grammatik zählte nicht: Kasusendungen, das Possessivadjektiv „Софіїн“ (Sofias), das Adjektiv „празький“ (Prager), Namen in Zeilen, die ich auf Spanisch geschrieben habe, und mein eigener Spitzname für Giovanni.
- Ausgelassene Zeilen: Sätze, Chatnachrichten oder Dialogzeilen, deren Inhalt in der Übersetzung fehlt.
- ти/ви-Ausrutscher: Ein Freund spricht einen anderen Freund mit dem formellen „ви“ an. Die höfliche Anrede bei der ersten Begegnung mit einem Fremden zählte nicht, ebenso wenig ein „ви“ an eine ganze Gruppe.
Zwei KI-Juroren verschiedener Anbieter, Claude Opus 5.5 und Gemini 3.1 Pro, haben jedes Kapitel jeder Version mit dem englischen Original abgeglichen. Ein Befund zählte nur, wenn beide ihn markierten und ein Skript den genauen Wortlaut im Text fand; anschließend haben wir jeden einzelnen im Kontext gelesen. Bei ausgelassenen Zeilen haben wir zusätzlich die Fragezeichen Kapitel für Kapitel verglichen – so fällt eine verlorene Zeile auch ganz ohne KI auf.
Wo gab es Abweichungen?
| Version | Namen mit wechselnder Schreibweise | Ausgelassene Zeilen | ти/ви-Ausrutscher |
|---|---|---|---|
| Google Translate | 1 | 0 | 5 |
| ChatGPT, neuer Chat pro Kapitel | 1 | 0 | 0 |
| ChatGPT, neuer Chat + Namensliste | 0 | 0 | 0 |
| Claude, eine Unterhaltung | 0 | 0 | 0 |
| Claude, neuer Chat pro Kapitel | 3 | 0 | 0 |
| Claude, neuer Chat + Namensliste | 0 | 0 | 0 |
| Gemini, eine Unterhaltung | 0 | 0 | 0 |
| Gemini, neuer Chat pro Kapitel | 2 | 0 | 0 |
| Gemini, neuer Chat + Namensliste | 0 | 0 | 0 |
| Transept | 0 | 0 | 0 |
Was passiert mit Namen in einem neuen Chat?
Darf ich vorstellen: Nazli, Sofias türkische Mitbewohnerin. Auf Ukrainisch lässt sich ihr Name als Назлі oder als Назли schreiben, und für sich genommen sehen beide Varianten gut aus. Jedes einzelne Kapitel liest sich also richtig – das Buch als Ganzes nicht.
Mit einem neuen Chat für jedes Kapitel schrieb Claude in den Kapiteln 2 und 7 insgesamt 24-mal „Назли“ und überall sonst „Назлі“. Gemini teilte sie genau andersherum auf: „Назли“ in sechs Kapiteln, „Назлі“ in drei. ChatGPT machte sie in den Kapiteln 5 und 7 zu „Назли“. Claude verwandelte außerdem Jeff zwei Kapitel lang in „Джеф“, eingerahmt von insgesamt drei Kapiteln mit „Джефф“, und Mariana im letzten Kapitel in „Мар’яна“, nachdem sie vier Kapitel lang „Маріана“ geheißen hatte.
Nichts davon passierte in einem einzigen langen Gespräch, in dem das Modell sehen kann, wie es Nazli in Kapitel 1 geschrieben hat. Und nichts davon passierte in einem neuen Chat mit eingefügter Namensliste. Eine Seite mit Namen behob jeden einzelnen Fall.
Google Translate kommt ohne Chat aus, und bei allen anderen Namen blieb es konsequent. Sein einziger Ausrutscher war Mariana, die in Kapitel 5 einmal zu „Мар’яна“ wurde – zwischen zwei „Маріана“.
Hat irgendein Tool Zeilen verschluckt?
Nein. Auf 14.919 Wörtern ging in keiner Version ein Satz, eine Chatnachricht oder eine Dialogzeile verloren. Beide Juroren fanden nichts, und jede Version behielt Kapitel für Kapitel die Fragezeichen des Originals bei (ChatGPT machte aus drei Fragen Aussagesätze, weil sich eine Runde „Ich hab noch nie“ auf Ukrainisch so natürlicher liest; die Zeilen sind aber alle da).
Ich hatte mit Lücken gerechnet. Fehlende Zeilen sind der Klassiker unter den Beschwerden über KI-Übersetzungen langer Texte – doch Kapitel für Kapitel übersetzt, im Oktober 2026, haben wir keine einzige entdeckt.
Seit wann sind wir per „ви“?
Hier fiel Google Translate zurück. Fünfmal wurde ein Freund plötzlich förmlich: Diego etwa, der Sofia mitten im Flirt fragt: „Зачекайте, і ви думаєте, що це багато?“, oder eine Postkarte, die Sofia an Nazli schreibt und die auf halber Strecke zum „ви“ wechselt. Keinem der Chatbots ist das auch nur ein einziges Mal passiert.
Unsere Vermutung: Ein Chatbot liest das ganze Kapitel auf einmal, und die Freundschaft steckt im Kapitel. Googles Übersetzer scheint jeweils viel weniger Text auf einmal zu betrachten und kann deshalb nicht erkennen, dass Diego und Sofia schon seit drei Kapiteln zusammen trinken.
Was ist uns sonst noch aufgefallen?
- Eine meiner Figuren heißt Ege. Auf Ukrainisch bedeutet „еге“ so viel wie „mhm“. Die meisten Versionen schrieben ihn „Еге“, sodass seine Nachrichten im Gruppenchat mit „Mhm:“ beginnen. Zwei schrieben ihn „Еґе“, mit dem harten ukrainischen ґ, und umschifften so den Witz.
- Gemini ließ eine Zeile auf Englisch stehen, und zwar in zwei seiner drei Durchläufe: „Diego! Man, good to see you!“
„Who tf is Claude?“ – wie haben die einzelnen Tools das übersetzt?
Aybars’ Frage in Kapitel 7 wurde zu einer regelrechten Stufenleiter ukrainischer Flüche. So lautet sie im Durchlauf mit neuem Chat bei jedem Tool:
| Tool | Übersetzung | Sinngemäß |
|---|---|---|
| Google Translate | «Хто такий Клод?» | „Wer ist Claude?“ (ganz ohne Fluchen) |
| Claude | – Хто в біса цей Claude? | „Wer zum Teufel ist dieser Claude?“ |
| ChatGPT | — Хто, бляха, такий Claude? | „Wer, verflixt noch mal, ist Claude?“ – mit einem höflichen Euphemismus |
| Gemini | «Хто такий, нахуй, Клод?» | das F-Wort, ungeschönt und in voller Wucht |
| Transept | — Це ще що за хрін? | „Was zum Kuckuck ist das denn?“ |
Google und Gemini machten aus Claude außerdem „Клод“, als wäre er Franzose. Die anderen behielten den Namen in lateinischer Schrift bei.
Welche Version las sich am besten?
Ob sich das Ukrainische mit Vergnügen lesen lässt, verrät keine Fehlerzählung – also haben wir die beiden Prüfer auch danach gefragt. Für drei Kapitel – das dialoglastige „The Devil Arrives“, das mehrsprachige „D7 Intro“ und das lange „Ginger beer“ – bekam jeder Prüfer den englischen Text und fünf ukrainische Versionen ohne Kennzeichnung, eine pro Tool, und brachte sie in eine Rangfolge, so wie es eine ukrainische Literaturlektorin tun würde. Jedes Kapitel ging zweimal an jeden Prüfer, die Versionen jeweils in anderer Reihenfolge. Die Chatbots arbeiteten mit ihren Namenslisten, sodass jedes Tool in Bestform antrat.
| Version | Durchschnittlicher Platz, Claude Opus als Prüfer | Durchschnittlicher Platz, Gemini Pro als Prüfer |
|---|---|---|
| Transept | 1,2 | 2,3 |
| Gemini | 2,3 | 1,0 |
| ChatGPT | 2,5 | 2,7 |
| Claude | 4,0 | 4,0 |
| Google Translate | 5,0 | 5,0 |
Platz 1 ist der beste von fünf Plätzen. Der Standard-Modus von Transept läuft auf Claude Opus 5.5 – demselben Modell, das auch einer der Prüfer ist.
Der Favorit jedes Prüfers läuft auf dem Modell des eigenen Hauses: Opus setzte Transept in fünf von sechs Fällen auf Platz eins, Gemini Pro setzte Gemini jedes Mal an die Spitze. Die oberen Tabellenplätze sollte man also mit diesem Wissen lesen. Beim Rest waren sich die Prüfer ausnahmslos einig. ChatGPT landete solide im Mittelfeld, Claude (Sonnet, das Modell des kostenlosen Tarifs) jedes Mal auf Platz vier und Google Translate in allen zwölf Rangfolgen auf dem letzten Platz.
Warum, verraten die Notizen der Prüfer. Claude ließ das „love“ in Diegos „Thank you, love“ auf Englisch stehen und übertrug „small talk“ Wort für Wort. Geminis Slang war der lebendigste der fünf und trug mitunter dicker auf als mein Original. Google machte Grammatikfehler, wie sie keinem Chatbot unterliefen: Sofia, eine Frau, antwortet mit „Sure, I’m free“ – in der männlichen Form.
Was war der schlimmste Fehler?
Er ging auf Googles Konto, und er steckte in einem einzigen Wort. Sofia fragt Diego lachend: „Are you kidding me? That’s why you ghosted me?“ Google Translate schrieb „Тому ти мене й зґвалтував?“, und das bedeutet: „Deshalb hast du mich also vergewaltigt?“
Aus einem Rom-Com-Moment wurde der Vorwurf einer Straftat – in flüssigem, korrektem Ukrainisch, ohne dass irgendetwas auf der Seite einen Leser warnen würde, der das Englische nicht kennt. Wenn Sie aus diesem Test nur eines mitnehmen, dann das: Lesen Sie jede Zeile einer maschinellen Übersetzung, bevor es jemand anderes tut.
Was sollten Sie tun, wenn Sie Ihr Buch mit KI übersetzen?
- Geben Sie dem Tool Ihre Namen einmal vor und sorgen Sie dafür, dass es dabei bleibt. Bei einem Chatbot heißt das: eine einzige lange Unterhaltung oder eine Namensliste, die Sie in jeden neuen Chat einfügen. Bei einem Übersetzungstool heißt das: ein Glossar.
- Lesen Sie die Dialoge laut vor, und zwar in der neuen Sprache, und hören Sie genau hin, ob ein Freund auf einmal klingt wie eine Bank.
- Prüfen Sie die Kapitel, in denen ein neuer Chat begann. Genau dort sind in diesem Test sämtliche Namen verrutscht.
- Testen Sie das Tool an Ihren eigenen Kapiteln, nicht an einem Probeabsatz. Die Probleme fangen erst an, wenn das Buch lang wird.
Was dieser Test nicht zeigt
- Ein Buch, eine Richtung. Englisch ins Ukrainische, Gegenwartsliteratur mit viel Dialog. Eine Fantasy-Saga mit 200 erfundenen Namen oder eine Übersetzung aus dem Japanischen ins Englische würde die Tools ganz anders fordern.
- Die Chatbots liefen über ihre APIs, und zwar mit den Modellen ihrer kostenlosen Tarife, ohne die eigenen Anweisungen und das Gedächtnis der Apps. Die Apps von ChatGPT, Claude und Gemini verhalten sich womöglich etwas anders.
- Die Juroren sind KIs. Zwei an der Zahl, von unterschiedlichen Anbietern; jeder Befund wurde per Skript am Text überprüft und anschließend im Kontext gelesen. Einen Juror von OpenAI gab es nicht.
- Transept stammt von uns. Wir haben es so eingesetzt, wie wir es Autorinnen und Autoren empfehlen – mit Glossar und dem Roman-Workflow –, und wir haben jede einzelne Ausgabe aufbewahrt.
Autor
Mitgründerin von Transept. Drei Abschlüsse in englischer Sprache und Literatur – Kyiv, Ostrava und ein Jahr in Salzburg – und gebürtige Ukrainerin, die den Großteil ihres Schreiblebens auf Englisch verbringt. Kam als Prompt Engineer zur KI, dann Produkt- und Lifecycle-Marketing. Sie schreibt halbfiktionale Geschichten über echte Menschen und kreist immer wieder um die Frage, was zwischen Sprachen verloren geht.