我用 ChatGPT、Claude、Gemini 和谷歌翻译翻了自己的小说,结果是这样的
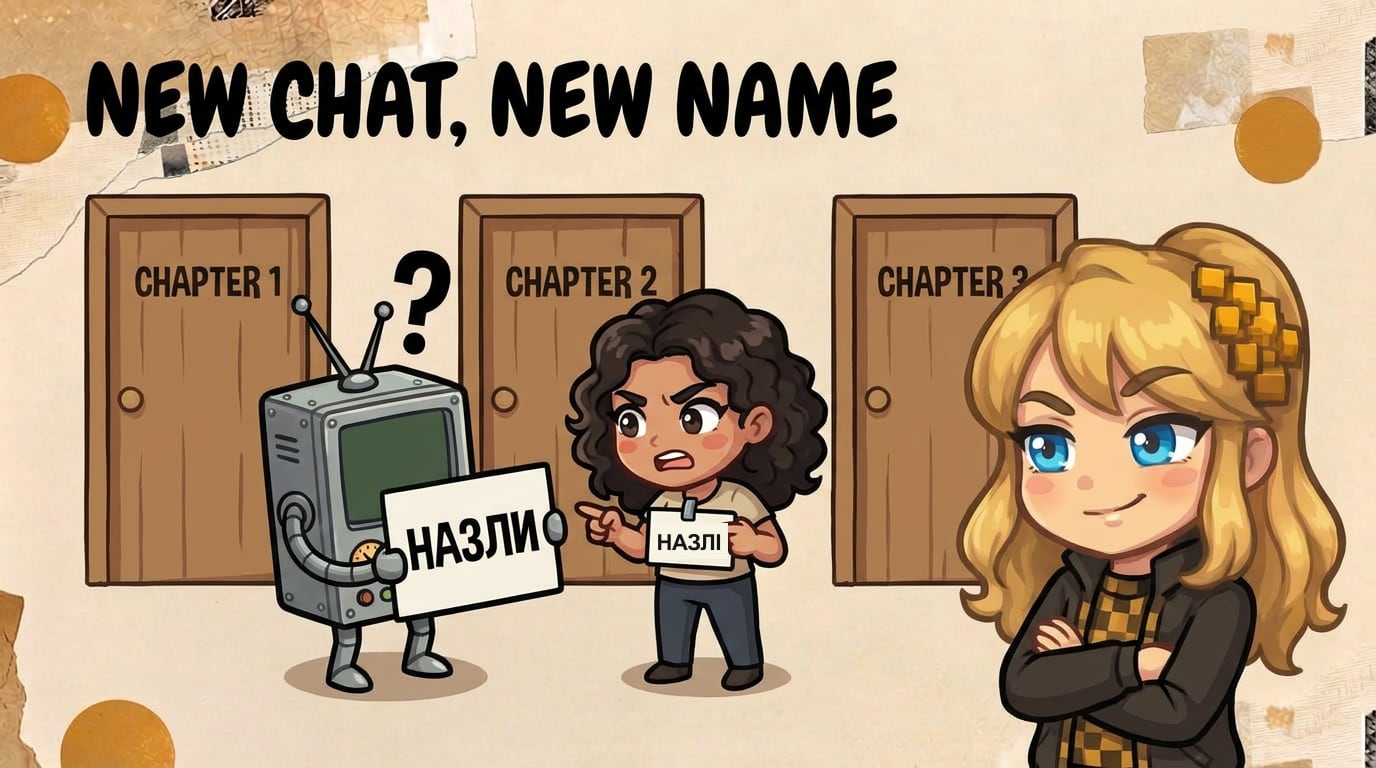
我们用谷歌翻译、ChatGPT、Claude、Gemini 和 Transept,把我小说的九个章节(共 15,000 词)从英语译成乌克兰语,然后逐一清点:哪些名字的拼写变了,哪些句子被漏掉了,又有哪些朋友突然客套起来、改口称“您”。在同一个长对话里,聊天机器人还能把名字保持统一;一换成新对话,就乱了套。
本页内容
我正在写一部小说,讲的是一群在俄斯特拉发交换的伊拉斯谟学生。书里有一位乌克兰女主角、一个爱撩人的西班牙人、几个土耳其室友、一个昼夜不停的宿舍群聊,还有喝不完的啤酒。第 7 章里,Sofia 跟朋友 Aybars 说起 Claude,他问:“Claude 又是哪根葱?”她解释道:“跟 ChatGPT 差不多,但不一样。更好。更聪明……”
所以,当我们想弄清楚哪款 AI 工具能让一部小说前后保持一致时,该用哪本书,我心里早就有数。这次测试逼着 ChatGPT 和 Claude 去翻译一句给它们俩排高下的话。(两者都老老实实照译了。谁也没替自己辩解。)
我们测了什么?
我们用作家最可能先上手尝试的各款工具,把我小说的前九章从英语译成乌克兰语,再统计章与章之间出现了哪些变化。
| 项目 | 方法 |
|---|---|
| 原文 | 我正在创作的小说第 1–9 章:共 14,919 词、737 个段落,涉及 25 个有名有姓的人物和地点 |
| 翻译方向 | 英语 → 乌克兰语 |
| 谷歌翻译 | 使用免费的“文档”标签页,将整份节选作为一个 Word 文件上传 |
| ChatGPT、Claude、Gemini | 截至 2026 年 10 月各家免费版所用的模型:GPT-6 Luna、Claude Sonnet 5.5 和 Gemini 3.8 Flash,均通过各公司的 API 调用 |
| Transept | “小说或书籍”工作流(翻译、对照原文校对、名字核查),采用标准模式(底层模型为 Claude Opus 5.5),并配有一份收录同样 25 个名字的术语表 |
| 日期 | 2026 年 10 月 19–20 日 |
每个聊天机器人我们都用三种方式各跑了一遍,因为作家们平时也正是这么用的:
- 同一个长对话:先说一句“我会把我的小说一章一章发给你”,然后在同一个对话里逐章发送。
- 每章开一个新对话:对话拉得太长、只好另起一个时,就是这种情况。
- 每章开一个新对话,并粘贴一份名字清单:“请使用以下乌克兰语拼法:Nazli → Назлі,Jeff → Джефф……”
每次都附上同样一段简短的要求:完整翻译本章,保留原文的语气、笑话、俚语和格式。
为什么译成乌克兰语?
因为乌克兰语能让错误变得可以清点。名字会随格变换词尾(Софія、Софії、Софією),所以译文若把同一个人写成两种拼法,很容易和正常的语法变化区分开来。另外,乌克兰语要求每个说话人都在非正式的“ти”和正式的“ви”之间做出选择。朋友之间第 2 章还互称“ти”,到第 6 章却改口称“ви”,母语读者一眼就能察觉这种失误,脚本也能把它揪出来。
我们是怎么统计的?
每个版本我们都统计了三项:
- 拼写变了的名字:同一个名字在九章中前后拼写不一。语法变化不算在内:格词尾、所有格形式“Софіїн”(Sofia 的)、形容词“празький”(布拉格的)、我用西班牙语写的句子里出现的名字,以及我自己给 Giovanni 起的昵称。
- 漏掉的句子:译文中内容缺失的句子、聊天消息或对白。
- ти/ви 错用:一位朋友用正式的“ви”称呼另一位朋友。初次见到陌生人时客气称呼不算,对一群人说“ви”也不算。
我们请来两名分属不同公司的 AI 评审——Claude Opus 5.5 和 Gemini 3.1 Pro——对照英文原文审读每个版本的每一章。只有两者都标记出来、且脚本在文本中找到了对应的原话,才算一处问题;之后我们再结合上下文逐条核读。至于漏掉的句子,我们还逐章比对了问号的数量,这样不借助任何 AI,也能查出哪里丢了一句。
哪些地方走了样?
| 版本 | 拼写变了的名字 | 漏掉的句子 | ти/ви 错用 |
|---|---|---|---|
| 谷歌翻译 | 1 | 0 | 5 |
| ChatGPT,每章开一个新对话 | 1 | 0 | 0 |
| ChatGPT,每章新对话 + 名字清单 | 0 | 0 | 0 |
| Claude,同一个长对话 | 0 | 0 | 0 |
| Claude,每章开一个新对话 | 3 | 0 | 0 |
| Claude,每章新对话 + 名字清单 | 0 | 0 | 0 |
| Gemini,同一个长对话 | 0 | 0 | 0 |
| Gemini,每章开一个新对话 | 2 | 0 | 0 |
| Gemini,每章新对话 + 名字清单 | 0 | 0 | 0 |
| Transept | 0 | 0 | 0 |
换了新对话,名字会怎样?
来认识一下 Nazli,Sofia 的土耳其室友。她的名字在乌克兰语里既可以写作 Назлі,也可以写作 Назли,单看哪种都没毛病。于是每一章读起来都对,整本书却不对了。
Claude 每章开一个新对话时,在第 2 章和第 7 章把她写成了“Назли”,共 24 次,其余章节都写作“Назлі”。Gemini 的分法恰好反过来:六章用“Назли”,三章用“Назлі”。ChatGPT 则在第 5 章和第 7 章把她写成了“Назли”。Claude 还有两章把 Jeff 写成了“Джеф”,夹在三章“Джефф”中间;Mariana 前四章都是“Маріана”,到了最后一章却变成了“Мар’яна”。
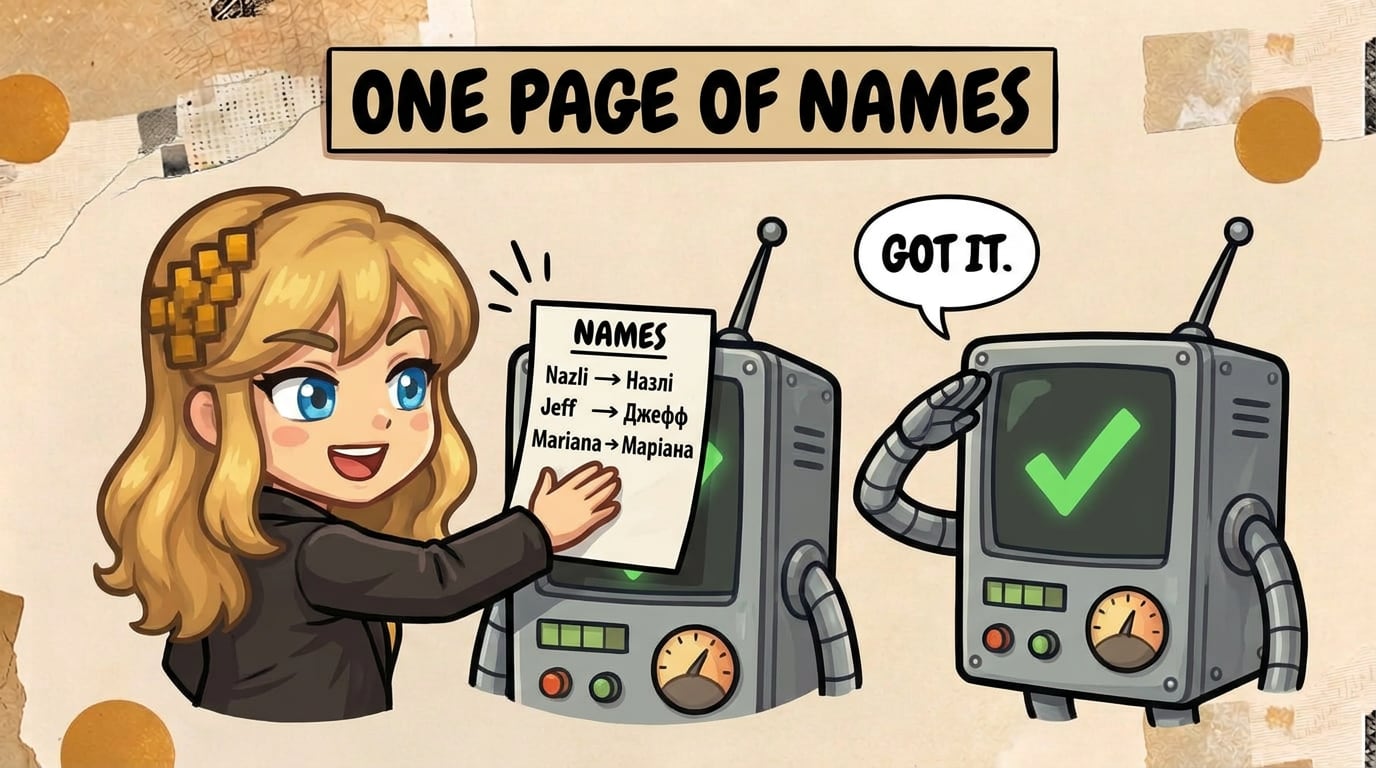
放在同一个长对话里翻译时,这些问题一个都没出现——模型看得到自己在第 1 章是怎么写 Nazli 的。每章开新对话、但贴上一份名字清单时,同样一个都没出现。一页名字清单,就把所有问题都解决了。
Google Translate 用不着对话,其他名字也都译得很稳。它唯一的失误出在 Mariana 身上:第 5 章里,前后都是“Маріана”,中间却有一处变成了“Мар’яна”。
有没有工具漏译?
没有。这 14,919 个单词里,没有哪个版本漏掉过一句话、一条聊天消息或一句对白。两位评审都没找出任何遗漏,而且每个版本都逐章保留了原文的问号(ChatGPT 的版本把其中三处问句改成了陈述句,因为“我从来没有”这个游戏在乌克兰语里这么说更自然;句子一句不少)。
我本以为多少会漏掉一些。漏句是人们对 AI 翻译长文本的经典抱怨,可在 2026 年 10 月、一次只翻一章的情况下,我们一处都没见到。
咱们什么时候用上“ви”了?
正是在这一点上,Google Translate 落了下风。有五次,朋友之间突然客气起来,改口用了敬称“ви”(您):Diego 正调着情,却问 Sofia“Зачекайте, і ви думаєте, що це багато?”;还有一张 Sofia 写给 Nazli 的明信片,写到一半就换成了“ви”。聊天机器人们一次都没犯过这种错。
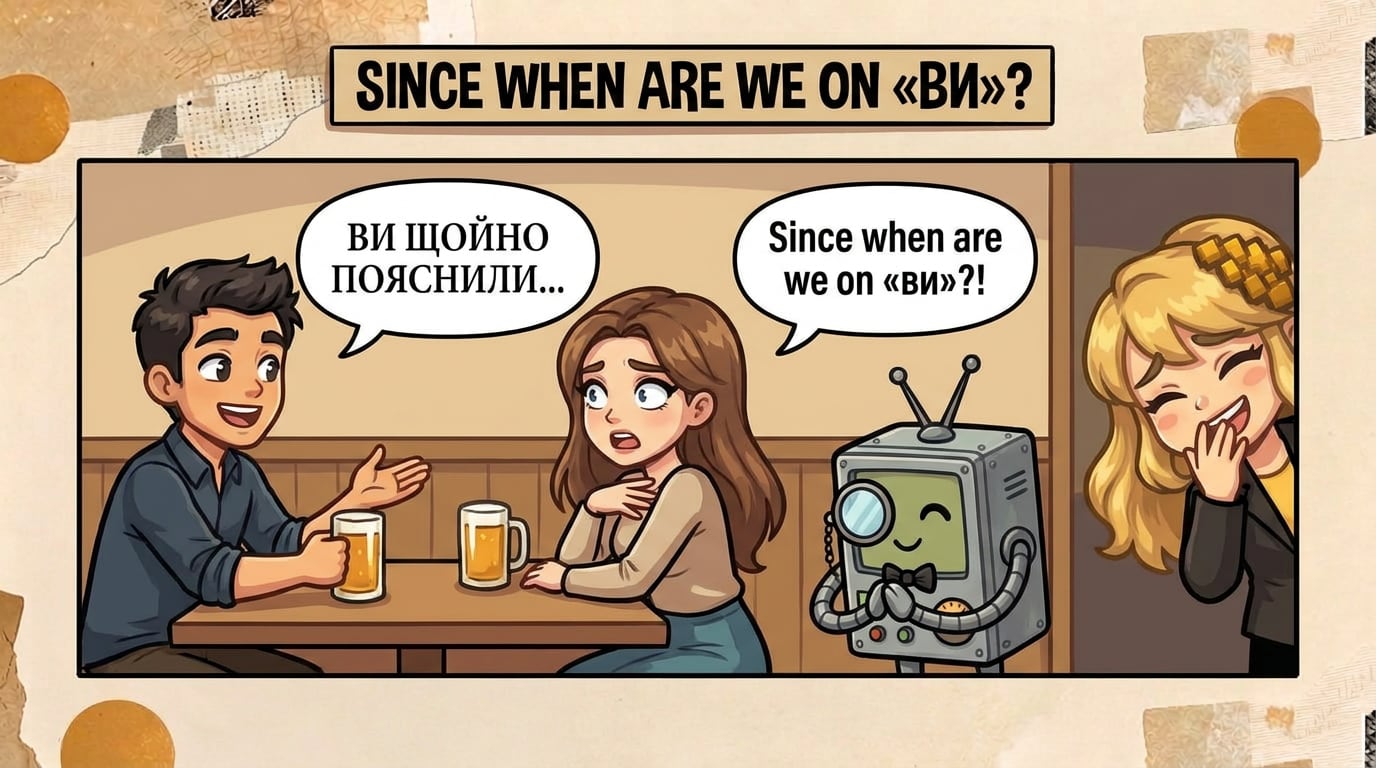
我们猜原因是这样的:聊天机器人一次读完整章,而两人的交情就写在这一章里。Google 的翻译器每次看到的文本似乎要少得多,所以它看不出 Diego 和 Sofia 已经一起喝了三章的酒。
我们还发现了什么?
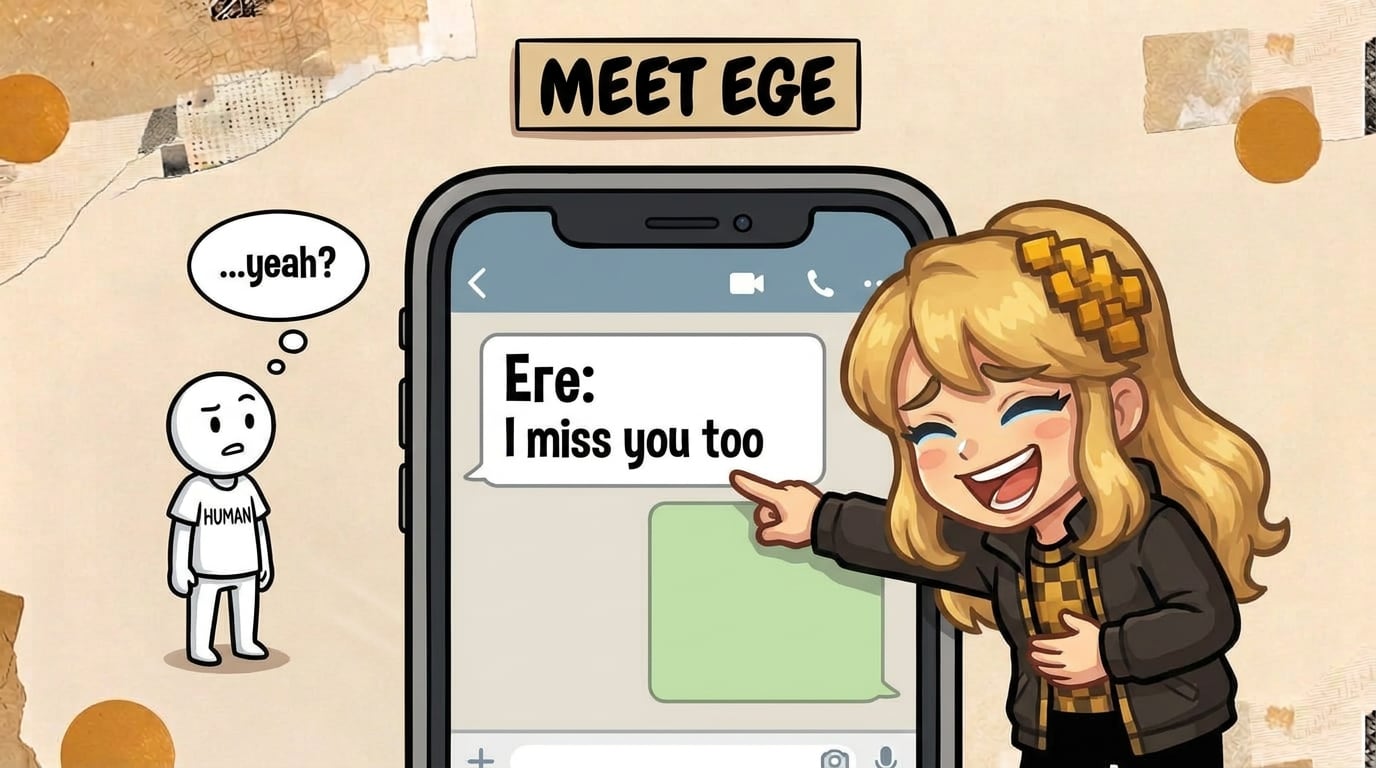
- **我有个角色叫 Ege。**在乌克兰语里,“еге”的意思是“嗯哼”。大多数版本把他写成“Еге”,结果他在群聊里的每条消息都像是以“嗯哼:”开头。有两个版本拼成了“Еґе”,用上乌克兰语特有的硬音 ґ,躲过了这个笑话。
- Gemini 有一句话原样留成了英文,三次测试里有两次都这样:“Diego! Man, good to see you!”
各个工具是怎么翻译“Who tf is Claude?”的?
Aybars 在第 7 章里的这句提问,到了乌克兰语里,变成了一道由轻到重的脏话阶梯。下面是各个工具在新对话中给出的译法:
| 工具 | 译文 | 大意 |
|---|---|---|
| Google Translate | «Хто такий Клод?» | “Claude 是谁?”(一个脏字都没有) |
| Claude | – Хто в біса цей Claude? | “见鬼,这个 Claude 到底是谁?” |
| ChatGPT | — Хто, бляха, такий Claude? | “Claude 他喵的到底是谁?”,用了个委婉的替代说法 |
| Gemini | «Хто такий, нахуй, Клод?» | 火力全开的 F 字头脏话 |
| Transept | — Це ще що за хрін? | “这又是什么鬼?” |
Google 和 Gemini 还把 Claude 写成了“Клод”,仿佛他是个法国人。其他几个工具则保留了拉丁字母的原名。
哪个版本读起来最好?
数错误只能看出错得多不多,看不出乌克兰语译文读起来是否赏心悦目,所以这一点我们也请两位评审评了。我们挑了三章:对白密集的“The Devil Arrives”、多种语言混杂的“D7 Intro”,以及篇幅很长的“Ginger beer”。每位评审拿到英文原文和五个不标来源的乌克兰语版本(每个工具一个),像乌克兰的文学编辑那样给它们排名。每一章都交给每位评审各看两遍,两遍的版本顺序各不相同。聊天机器人都配上了名称表,好让每个工具都拿出最佳状态。
| 版本 | 平均名次(Claude Opus 评审) | 平均名次(Gemini Pro 评审) |
|---|---|---|
| Transept | 1.2 | 2.3 |
| Gemini | 2.3 | 1.0 |
| ChatGPT | 2.5 | 2.7 |
| Claude | 4.0 | 4.0 |
| Google Translate | 5.0 | 5.0 |
第 1 名代表五个版本中最好的。Transept 的 Standard 模式基于 Claude Opus 5.5,和其中一位评审用的是同一个模型。
两位评审最偏爱的,恰好都基于自家公司的模型:Opus 六次里有五次把 Transept 排在第一,Gemini Pro 则每次都把 Gemini 排在第一。看表格前几名时,请把这一点放在心上。其余名次,两位评审的意见毫无例外地一致:ChatGPT 稳居中游,Claude(Sonnet,即其免费版所用的模型)每次都排第四,Google Translate 则在全部十二次排名中次次垫底。
评审的点评道出了原因。Diego 说“Thank you, love”时,Claude 把“love”原样留成了英文,还把“small talk”逐字硬译了过来。Gemini 的俚语是五个版本里最鲜活的,有时甚至比我原文写得还要出格。Google 则犯了任何一个聊天机器人都没犯过的语法错误:Sofia 明明是女性,回答“Sure, I’m free”时用的却是阳性形式。
最严重的错误是什么?
犯错的是 Google,而且只错了一个词。Sofia 笑着问 Diego:“Are you kidding me? That’s why you ghosted me?”(“你开什么玩笑?你就为这个玩消失?”)Google Translate 却译成了“Тому ти мене й зґвалтував?”,意思是“所以你就是为这个强奸了我?”
浪漫喜剧里的一个桥段,就这样变成了一项犯罪指控——用的还是通顺流畅、语法无误的乌克兰语,页面上没有任何迹象能提醒不懂英文原文的读者。如果这次测试你只记住一件事,那就记住这个:机器翻译的每一句,都要赶在别人读到之前亲自读一遍。
如果用 AI 翻译自己的书,该怎么做?
- **把人名一次性交代给工具,并让它始终照用。**在聊天机器人里,这意味着要么全程待在同一个长对话里,要么每开一个新对话都把人名表粘贴进去。在翻译工具里,这就是术语表。
- 用目标语言把对话大声读出来,留意有没有哪个朋友突然满口银行腔。
- **重点检查新开对话的那几章。**这次测试里,每个人名都是在那里走样的。
- 拿你自己的章节来测试工具,而不是随便找一段样例。麻烦是从书变长之后才开始的。
本次测试无法说明的问题
- **只有一本书,一个翻译方向。**英语译成乌克兰语,题材是对话很多的当代小说。换成有 200 个虚构人名的奇幻长篇,或是日译英,对这些工具的考验就会大不一样。
- 聊天机器人是通过 API 调用的,用的是各自免费版所用的模型,没有应用自带的指令和记忆功能。ChatGPT、Claude 和 Gemini 的应用本身,表现可能会略有不同。
- **评审是 AI。**一共两位,来自不同公司;每一条发现都先用脚本在文本中核实,再放回上下文中逐条阅读。评审里没有来自 OpenAI 的模型。
- **Transept 是我们做的。**我们按平时建议作者的方式来用它——配上术语表,走小说工作流程——并保留了每一份输出。
作者
Transept 联合创始人。拥有三个英语语言文学学位——曾求学于基辅、俄斯特拉发,并在萨尔茨堡度过了一年。作为乌克兰人,她的写作生涯却大多以英语进行。她最初作为提示词工程师进入 AI 领域,随后转向产品和生命周期营销。她撰写关于真实人物的半虚构故事,并不断探讨在语言转换中究竟丢失了什么。