自作の小説をChatGPT、Claude、Gemini、Google翻訳で翻訳してみた。その結果は?
執筆中の小説の9章分(15,000語)を、Google翻訳、ChatGPT、Claude、Gemini、Transeptで英語からウクライナ語に翻訳しました。そのうえで、表記が変わった名前、抜け落ちた行、急によそよそしい敬語を使い出した友人を、一つ残らず数えました。チャットボットは、一つの長い会話の中では名前の表記を守れていたものの、新しいチャットを立ち上げると崩れてしまいました。
目次
私はいま、チェコのオストラヴァで暮らすエラスムス留学生たちの小説を書いています。登場するのは、ウクライナ人のヒロイン、スペイン人のナンパ男、トルコ人のルームメイトたち、眠ることを知らない寮のグループチャット、そして大量のビール。第7章では、ソフィアが友人のアイバルスにClaudeの話をし、彼が「Who tf is Claude?」(Claudeってマジで誰だよ?)と聞き返します。ソフィアの答えはこうです。「ChatGPTみたいなものだけど、ちょっと違うの。もっと優秀で、もっと賢くて……」
そんなわけで、どのAIツールなら小説の一貫性を保てるのかを調べることになったとき、使う本は迷わず決まりました。このテストでは、ChatGPTとClaudeに、自分たちの優劣を語る一文を翻訳させることになったのです。(どちらも忠実に訳しました。言い返したモデルはいませんでした。)
何をテストしたのか
小説の最初の9章を、作家がまず試しそうなツールすべてで英語からウクライナ語に翻訳し、章が変わるごとに何がブレたかを数えました。
| 項目 | 内容 |
|---|---|
| 原文 | 執筆中の小説の第1〜9章:14,919語、737段落、名前のある人物・場所は計25 |
| 翻訳の方向 | 英語 → ウクライナ語 |
| Google翻訳 | 無料の「ドキュメント」タブを使用し、抜粋全体を1つのWordファイルとして翻訳 |
| ChatGPT、Claude、Gemini | 2026年10月時点で各社の無料プランに搭載されているモデル(GPT-6 Luna、Claude Sonnet 5.5、Gemini 3.8 Flash)を、それぞれのAPI経由で使用 |
| Transept | 「Novel or book」(小説・書籍)ワークフロー(翻訳、原文との照合による校正、名前チェック)をStandardモード(Claude Opus 5.5で動作)で使用。同じ25の名前を登録した用語集を併用 |
| 実施日 | 2026年10月19〜20日 |
チャットボットはそれぞれ3通りの方法で試しました。作家の使い方も、だいたいこの3通りだからです。
- 1つの長い会話:「これから小説を1章ずつ送ります」と伝えてから、同じチャットで各章を送る。
- 章ごとに新しいチャット:会話が長くなりすぎて、新しいチャットを立ち上げ直したときと同じ状況です。
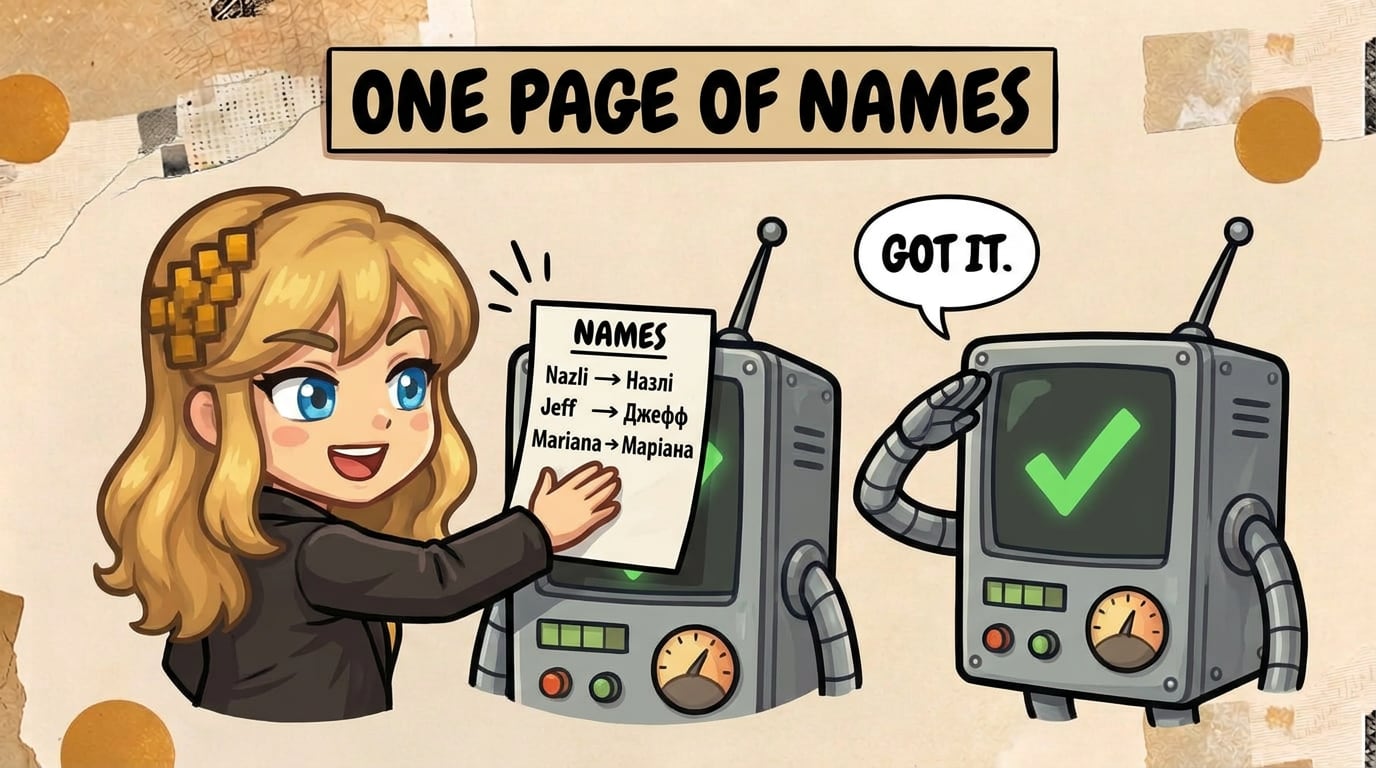
- 章ごとに新しいチャット+名前リストを貼り付け:「ウクライナ語の表記はこれを使ってください:Nazli → Назлі、Jeff → Джефф……」
依頼文はどの回も同じ短いものにしました。章を省略せずに全文翻訳し、トーン、ジョーク、スラング、書式はそのまま保つこと、というものです。
なぜウクライナ語に翻訳したのか
ウクライナ語なら、ミスを数えられるからです。名前には格変化の語尾がつく(Софія、Софії、Софією)ので、同じ人物を2通りに表記してしまった訳は、文法上の変化と簡単に見分けられます。さらにウクライナ語では、話し手は必ず、くだけた「ти」と丁寧な「ви」のどちらかを選ばなければなりません。第2章で「ти」で話していた友人同士が第6章で「ви」を使えば、ネイティブの読者はすぐに違和感を覚えますし、スクリプトでも検出できます。
どうやって数えたのか
各バージョンについて、次の3点を数えました。
- 表記が変わった名前:9章を通して、同じ人物の名前の表記が揺れたもの。文法によるものは数えていません。具体的には、格変化の語尾、所有形の「Софіїн」(ソフィアの)、形容詞の「празький」(プラハの)、私がスペイン語で書いたセリフ内の名前、そして作中で私がジョヴァンニにつけたあだ名です。
- 抜け落ちた行:原文の文、チャットメッセージ、セリフのうち、その内容が訳文から欠けているもの。
- ти/виの取り違え:友人が別の友人に対して、丁寧な「ви」で話しかけているもの。初対面の相手に丁寧に接する場面や、グループ全体に向けた「ви」は数えていません。
別々の企業が開発した2つのAI、Claude Opus 5.5とGemini 3.1 Proを審査役とし、全バージョンの全章を英語の原文と照らし合わせて読ませました。両方が指摘し、なおかつ該当する文言がスクリプトで本文中に確認できたものだけをカウントし、そのうえで一つひとつを文脈の中で読んで確かめています。抜け落ちた行については、章ごとに疑問符の数も比較しました。これなら、AIを一切介さずに欠落を見つけられます。
何がブレたのか
| バージョン | 表記が変わった名前 | 抜け落ちた行 | ти/виの取り違え |
|---|---|---|---|
| Google翻訳 | 1 | 0 | 5 |
| ChatGPT(章ごとに新しいチャット) | 1 | 0 | 0 |
| ChatGPT(新しいチャット+名前リスト) | 0 | 0 | 0 |
| Claude(一つの長い会話) | 0 | 0 | 0 |
| Claude(章ごとに新しいチャット) | 3 | 0 | 0 |
| Claude(新しいチャット+名前リスト) | 0 | 0 | 0 |
| Gemini(一つの長い会話) | 0 | 0 | 0 |
| Gemini(章ごとに新しいチャット) | 2 | 0 | 0 |
| Gemini(新しいチャット+名前リスト) | 0 | 0 | 0 |
| Transept | 0 | 0 | 0 |
新しいチャットだと、名前はどうなるのか?
ソフィアのトルコ人のルームメイト、ナズリを紹介しましょう。ウクライナ語では、彼女の名前は「Назлі」とも「Назли」とも書けて、どちらも単独で見ればおかしくありません。だから一章ずつ読めばどれも正しいのに、一冊の本としては成り立たなくなってしまうのです。
章ごとに新しいチャットで訳したClaudeは、第2章と第7章で計24回「Назли」と書き、ほかの章ではすべて「Назлі」にしました。Geminiは逆の割れ方で、6章が「Назли」、3章が「Назлі」。ChatGPTは第5章と第7章で彼女を「Назли」にしています。Claudeはさらに、ジェフを3章で「Джефф」と書きながら、そのあいだに挟まる2章だけ「Джеф」にし、マリアナも4章にわたって「Маріана」だったのに、最終章で「Мар’яна」に変えてしまいました。
一つの長い会話の中では、こうしたことは一度も起きませんでした。モデルが、第1章でナズリをどう書いたかを見返せるからです。名前リストを貼り付けた新しいチャットでも、やはり一度も起きていません。名前を並べたたった1ページで、すべてが解決したのです。
Google翻訳はそもそもチャットを必要とせず、ほかの名前はすべてぶれずに訳していました。唯一のミスはマリアナで、第5章で一度だけ、2つの「Маріана」に挟まれて「Мар’яна」になっていました。
訳抜けはあったのか
ありませんでした。14,919語のなかで、文やチャットのメッセージ、台詞を一つでも落としたバージョンはありません。審査役の2モデルも何も見つけられず、どのバージョンも章ごとに原文の疑問符をそのまま残していました(ChatGPTは3つを平叙文に変えていましたが、これは「Never Have I Ever」というゲームの場面で、ウクライナ語ではそのほうが自然に読めるからです。行自体はすべて残っています)。
多少はあるだろうと予想していました。長文のAI翻訳といえば、訳抜けは定番の不満です。ところが1章ずつ訳した場合、2026年10月時点では一つも見当たりませんでした。
いつから「ви」なんて他人行儀に?
ここでGoogle翻訳は後れを取りました。友人同士なのに、突然かしこまった口調になる箇所が5つあったのです。たとえば、口説いている最中のディエゴがソフィアに「Зачекайте, і ви думаєте, що це багато?」と尋ねる場面や、ソフィアがナズリに宛てた絵葉書が途中から「ви」に切り替わる場面です。チャットボットはどれも、一度もこうした間違いをしませんでした。
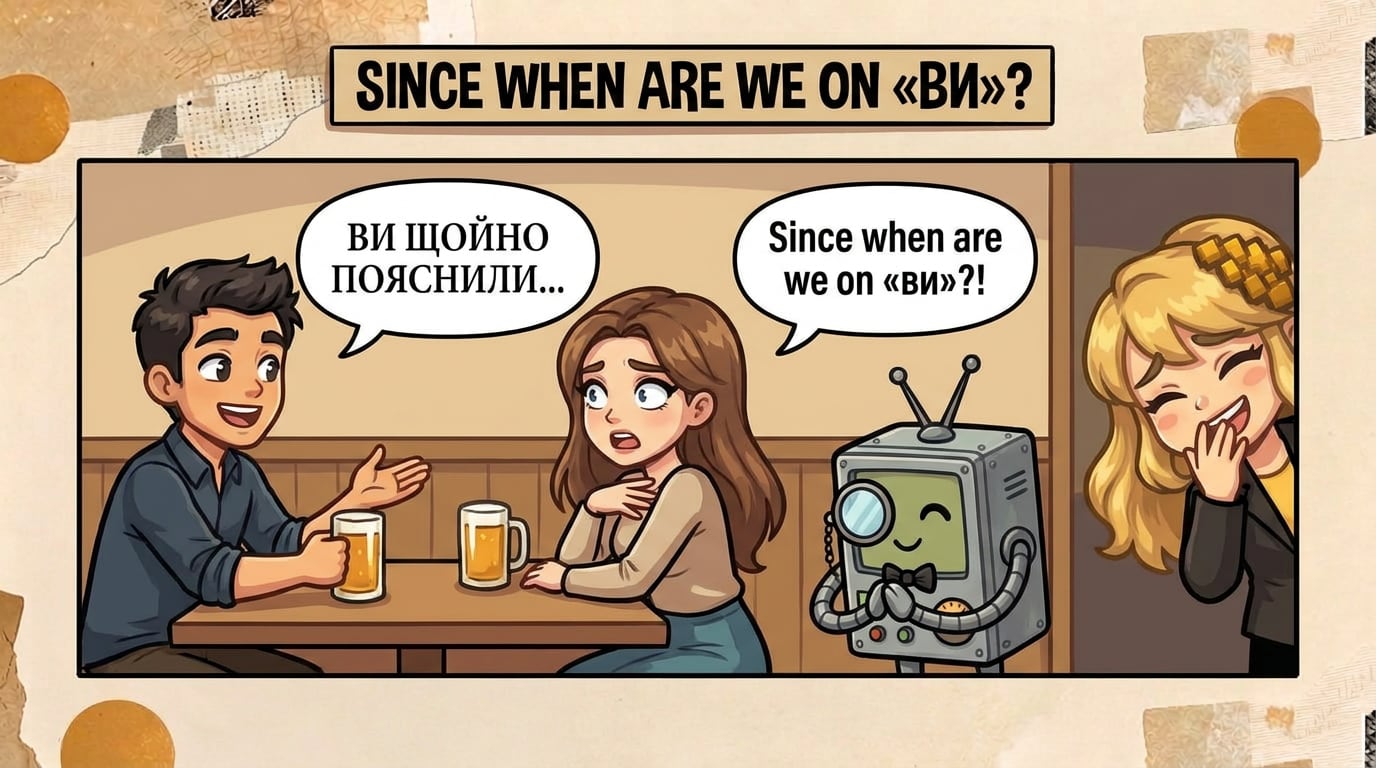
なぜこうなるのか。私たちの推測はこうです。チャットボットは章全体を一度に読みます。そして二人の友情は、その章の中に書かれています。一方、Googleの翻訳エンジンは一度に見るテキストがずっと短いらしく、ディエゴとソフィアがもう3章にわたって一緒に飲んできた仲だということが見えないのでしょう。
ほかに気づいたことは?
- 登場人物の一人に、エゲ(Ege)という男がいます。ところがウクライナ語の「еге」は「うん」という相槌。ほとんどのバージョンが彼を「Еге」と表記したため、グループチャットでの彼のメッセージは、どれも「うん:」で始まることになりました。2つのバージョンだけは、ウクライナ語特有の硬い「ґ」を使って「Еґе」と綴り、この笑い話を回避しています。
- 3回の試行のうち2回で、Geminiは1行を英語のまま残していました。「Diego! Man, good to see you!」
各ツールは「Who tf is Claude?」をどう訳したか
第7章でアイバルスが口にするこの問いは、訳すツールによって、ウクライナ語の罵り言葉の強さ比べのようになりました。以下は、各ツールを新しいチャットで実行したときの訳です。
| ツール | 訳文 | おおよその意味 |
|---|---|---|
| Google翻訳 | «Хто такий Клод?» | 「クロードって誰?」(罵り言葉はまったくなし) |
| Claude | – Хто в біса цей Claude? | 「このClaudeって、いったい誰なんだよ?」 |
| ChatGPT | — Хто, бляха, такий Claude? | 「Claudeって、ク……誰なんだよ?」(罵り言葉を上品にぼかした婉曲表現) |
| Gemini | «Хто такий, нахуй, Клод?» | ぼかしなし、正真正銘のFワード |
| Transept | — Це ще що за хрін? | 「そりゃいったい何なんだ?」 |
Google翻訳とGeminiはさらに、Claudeをまるでフランス人であるかのように「Клод」と表記していました。ほかのツールは、名前をラテン文字のまま残しています。
いちばん読みやすかったのはどのバージョンか
ミスを数えても、そのウクライナ語が読んでいて心地よいかどうかまではわかりません。そこで、この点も2つの審査員モデルに評価してもらいました。対象にしたのは3つの章です。台詞の多い「The Devil Arrives」、複数の言語が入り混じる「D7 Intro」、そして長い「Ginger beer」。各審査員には英語の原文と、ツールごとに1つずつ、どのツールの訳かを伏せた5つのウクライナ語訳を渡し、ウクライナの文芸編集者になったつもりで順位をつけてもらいました。どの章も訳の並び順を変えて、審査員ごとに2回ずつ評価してもらっています。チャットボットには名前リストを渡して実行したので、どのツールも万全の状態で臨んだことになります。
| バージョン | 平均順位(審査員:Claude Opus) | 平均順位(審査員:Gemini Pro) |
|---|---|---|
| Transept | 1.2 | 2.3 |
| Gemini | 2.3 | 1.0 |
| ChatGPT | 2.5 | 2.7 |
| Claude | 4.0 | 4.0 |
| Google翻訳 | 5.0 | 5.0 |
5つの中で最も優れたものが1位です。TranseptのStandardモードはClaude Opus 5.5で動いており、審査員の一方と同じモデルです。
どちらの審査員も、自社のモデルで動くツールを最も高く評価しました。OpusはTranseptを6回中5回1位に、Gemini ProはGeminiを毎回1位に選んでいます。表の上位は、その点を差し引いて見てください。それ以外については、両者の評価は例外なく一致しました。ChatGPTは安定して中位、Claude(無料プランで使われるモデルのSonnet)は毎回4位、そしてGoogle翻訳は12回のランキングすべてで最下位でした。
その理由は、審査員のコメントを読むとわかります。Claudeは、ディエゴが「Thank you, love」と言う場面で「love」を英語のまま残し、「small talk」も一語一語そのまま直訳していました。Geminiのスラングは5つの中でいちばん生き生きしていましたが、ときには私が書いた以上に踏み込みすぎていました。Google翻訳は、チャットボットには一度も見られなかった文法ミスを犯していました。女性であるソフィアの「Sure, I’m free」という返事を、男性形で訳していたのです。
最悪のミスは何だったのか
それはGoogle翻訳のミスで、たった一語のうちに起きました。ソフィアが笑いながらディエゴに尋ねる場面です。「冗談でしょ? それで私の前から消えたの?」 Google翻訳はこれを「Тому ти мене й зґвалтував?」と訳しました。意味は「だから私をレイプしたの?」です。
ラブコメの軽いひと幕が、犯罪を告発するセリフに変わってしまったのです。しかも流暢で文法的にも正しいウクライナ語で書かれているため、英語を知らない読者が異変に気づく手がかりは、ページのどこにもありません。このテストから一つだけ持ち帰るなら、これにしてください。機械翻訳は、ほかの誰かが読む前に、一行残らず自分で読むこと。
AIで自分の本を翻訳するなら、何をすべきか
- 名前は一度ツールに伝え、それを守らせましょう。チャットボットなら、一つの長い会話の中で作業を続けるか、新しいチャットを始めるたびに名前のリストを貼り付けます。翻訳ツールなら、用語集を使います。
- 翻訳先の言語で会話文を声に出して読み、友人が急に銀行の窓口のような口調になっていないか、耳を澄ませてください。
- 新しいチャットを始めた章をチェックしましょう。このテストで名前の表記がぶれたのは、すべてそこでした。
- サンプルの段落ではなく、自分の原稿の章でツールを試しましょう。問題が出てくるのは、本が長くなってからです。
このテストでわからないこと
- 対象は1冊、翻訳の方向も1つだけ。英語からウクライナ語への、会話の多い現代小説です。架空の名前が200も登場するファンタジー大作や、日本語から英語への翻訳なら、ツールにかかる負荷はまた違ってくるでしょう。
- チャットボットはAPI経由で実行しました。使ったのは各社の無料プランと同じモデルで、アプリ独自の指示やメモリ機能は働いていません。ChatGPT、Claude、Geminiのアプリでは、多少違う結果になる可能性があります。
- 審査役はAIです。異なる企業の2つのモデルを使い、指摘はすべてスクリプトで本文と照合したうえで、文脈の中で読んで確かめました。OpenAIのモデルは審査役に含まれていません。
- Transeptは私たちが作っている製品です。書き手の皆さんに勧めているとおりの使い方、つまり用語集と長編小説向けのワークフローを使って実行し、出力はすべて保存してあります。
著者
Transept共同創業者。キーウ、オストラヴァ、そしてザルツブルクでの1年間を経て、英語学・英文学の学位を3つ取得。ウクライナ出身ですが、書くのはほとんど英語です。プロンプトエンジニアとしてAIの世界に入り、その後はプロダクトマーケティングとライフサイクルマーケティングを担当。実在の人物をもとにしたセミフィクションを書きながら、言語のあいだで何がこぼれ落ちるのかという問いを追い続けています。