イタリックなし、スペースなし、「あなた」なし:日本語が教えてくれたローカライズの教訓
私たちはTranseptをわずか1日で日本語にローカライズしました。先行した10言語の経験があったので準備万全だと思っていましたが、まったくそんなことはありませんでした。偽のイタリック、2つのスタイル基準で意見が割れるスペース問題、日本語になると意味が変わってしまう言葉、2通りの表記があるカタカナ名、そしてアシスタントがアニメのヒロインのような口調になってはならない理由についてご紹介します。
目次
7月、私たちは週末だけでTranseptを10言語にローカライズし、4種類の複数形、性別で変わる敬語、ちょうど100万のときだけ現れる複数形など、あらゆるケースを経験した気になっていました。そのため、日本語の追加を決めたときも(マンガの翻訳対応を控えており、自分の作品を英語に訳したい日本の書き手こそ、Transeptがいちばん役に立てる相手です)、手慣れた手早い作業になるだろうと高をくくっていました。
確かに作業はすぐ終わりました。1日でアプリの全4,357件の文字列が日本語になり、サイトの各ページ、ヘルプセンター、ジャーナル、法的ページも揃いました。しかし、まったく手慣れた作業などではありませんでした。日本語には複数形の区別がないため、前回の文法知識は何の役にも立たなかったのです。それどころか、フォントに何ができるか、スペースをどこに入れるべきか、日本語では無害に見えて実はそうではない英単語はどれかといった、これまで言語の問題だとは思いもしなかったような壁が次々と立ちはだかりました。
ブラウザは偽のイタリックを合成してしまう
日本語サイトで真っ先に気づいたのは、見出しの文字が斜めに傾いていることでした。
私たちのデザインでは、強調のためにイタリック(斜体)を使用しています。引用文、見出しの強調語句、Visionのタイトル、書籍風の読書ビューなどです。しかし、日本語フォントにはイタリック体がありません。それでもCSSで指定されると、ブラウザは拒否することなく、直立したグリフを無理やり傾けて表示します。この傾斜処理は*シンセティック・オブリーク(合成斜体)*と呼ばれ、かなや漢字に適用されると印刷ミスのようにも見えてしまいます。
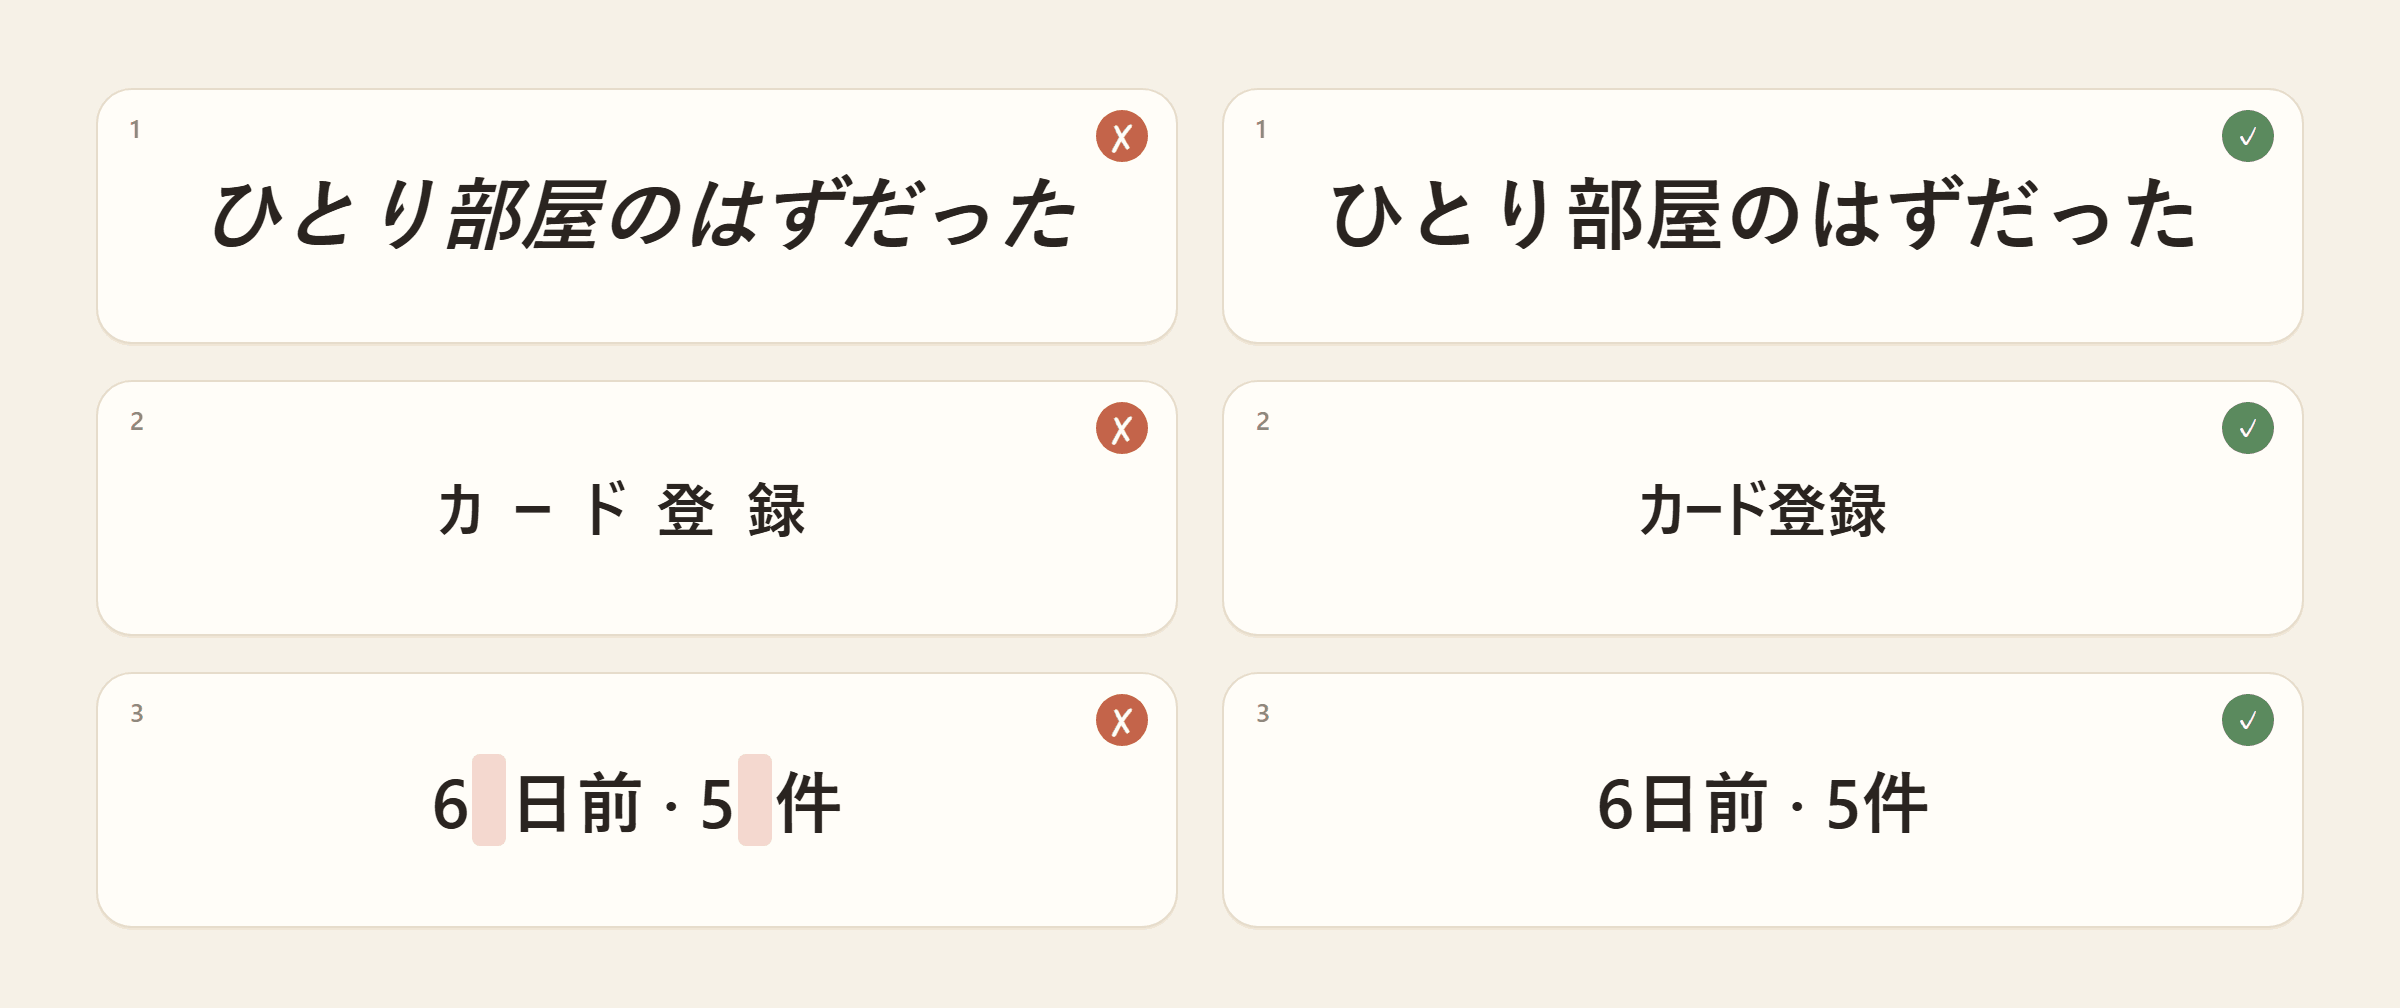
欧米向けのスタイルシートが日本語を壊す3つのパターン。1:偽のイタリック。2:ラテン文字の大文字ラベル用の文字間隔(letter-spacing)。3:数字と助数詞の間のスペース。
解決策はCSSのルール1行です。:lang(ja) に対してブラウザのスタイル合成を無効化し、すべて直立表示に設定します。日本語の強調は「かぎ括弧」、太字、または文字の上の点(傍点)で行うものであり、決して斜体にはしません。同じ見直しの過程で、画像にある2つ目の問題も見つかりました。大文字の小さなラベルには広めの文字間隔(トラッキング)を設定していましたが、これはラテン文字の大文字なら理にかなっています。しかし、それをかな文字に適用すると、「カード登録」(“add a card”)がどもっているかのように見えてしまうのです。
中国語はスペースを入れ、日本語は決してスペースを打たない
前回、中国語では漢字とラテン文字の間に細いスペースを入れる(「使用 Transept 翻译」)と書きました。日本語も同じだろうと思い込んでいました。ところが、スタイル基準同士で意見が割れていたのです。マイクロソフトの日本語スタイルガイドではスペースを入れます(「Word を使用」)。一方、日本翻訳連盟のスタイルガイドでは、基本ルールの第10項でこれを禁じており、全角文字と半角文字の間にスペースを入れてはならないと定められています。私たちは日本の翻訳者が準拠している連盟の基準に従うことにしたため、「Transeptで翻訳」「10MB」「5件」と、すべて隙間なく詰めて表記しています。
文字体系の多くを共有する2つの言語が、スペース1つを巡って意見を異にしています。やはり、言語の系統樹など何のあてにもなりません。
| 中国語(zh) | 日本語(ja) | |
|---|---|---|
| 漢字とラテン文字の間のスペース | あり:使用 Transept 翻译 | なし:Transeptで翻訳 |
| 数字と助数詞・単位の間のスペース | あり:5 个文档 | なし:5件 |
| イタリック | なし | なし |
| 複数形 | 1 | 1 |
| 引用符 | “” | 「」、書名には『』 |
ブラウザに描画を任せれば、日本語でもスペースの見た目は美しく保てます。CSSには text-autospace があり、レンダリング時に異なる文字体系の間に極細の隙間を挟んでくれるため、文字列そのものに文字が混ざることはありません。私たちは日本語でこれを有効にし、手動でスペースを打ち込むのをやめました。
防ぎきれなかったスペースは、別のところからやってきました。JavaScript自体の内蔵日付フォーマッタである Intl.RelativeTimeFormat は、「6 日前」(“6 days ago”)のように数字と助数詞の間にスペースを入れて返してきます。このスペースはロケールデータそのものに起因するもので、日本語の組版では使われないため、私たちのコード側で日本語向けにこれを除去するようにしました。コード上で組み立てるカウント表記はすべて同様に処理され、「5件」「1分35秒」といった形に整えられました。
日本語になると意味が変わってしまう言葉
日本のソフトウェアには英語の借用語があふれており、まさにそこが落とし穴になります。下の表の各行は、英単語に対してパッと思い浮かぶ日本語訳ですが、どれも日本語の読者にはまったく別の意味として伝わってしまいます。
| 英語 | パッと思い浮かぶ日本語訳 | 日本語の読者に伝わる意味 | 私たちが採用した表現 |
|---|---|---|---|
| word(単語数) | ワード | Microsoft Word | 英語の長さには「語」、日本語には「文字」 |
| credit card | クレジットカード | 「クレジット」が課金単位であるため、サービス内のクレジットを購入するためのカード | カード |
| proofread | 校閲 | ファクトチェック(事実確認) | 校正 |
| proofread(自らの文章) | 推敲 | 作家が自らの文章を練り直すこと | 校正 |
| you | あなた | UI上では冷たく、やや責め立てるような響きがある | 主語を省く |
| ページタイトル内の「Free!」 | 【無料】 | アフィリエイトブログ | 括弧なし |
なかでも最も重要だったのが、料金請求に関する表現です。Transeptは英語の原文を単語数でカウントしますが、日本語には単語ごとの空白(スペース)がありません。そのため中国語と同様に、日本語の原文は1文字単位で計算されます。ここでの「語」と「文字」は単なる言い回しの違いではなく、全く異なる2つの計量単位であり、料金ページでは正確に使い分けなければなりません。
そうしたルールの中で私が一番気に入っているのは、2008年にマイクロソフトが決めたものです。それまで知る由もなかったのですが、英語由来のカタカナ表記において、語尾が「-er」の言葉は長音符号を残し(ユーザー/user)、「-y」で終わる言葉は4文字以上になると長音を省く(メモリ/memory)という決まりです。だから「Translation memory」は「翻訳メモリー」ではなく「翻訳メモリ」であり、ネイティブの読者ならどちらの書き方でもすぐ気づきます。
Literessをアニメのヒロインのように喋らせてはならない
アプリ内アシスタントのLiteressは女性という設定ですが、日本語にするにあたって英語では考えもしない問題が浮上しました。文末をどう結ぶか、という点です。
日本のフィクションには役割語、つまり登場人物のキャラクター類型を示す特有の言葉遣いがあります。「女性らしい」とされる「〜わ」「〜のよ」「〜かしら」といった文末表現はその代表例です。言語学者によればこれらは明治時代のステレオタイプに端を発するもので、現代日本の生身の女性が使うことはほとんどありません。しかしフィクション、とりわけ翻訳小説の世界には色濃く生き残っており、翻訳小説は翻訳モデルが学習してきた文章のかなりの部分を占めています。そのため、AIモデルに「明るい女性アシスタント」のトーンで日本語を話させようとすると、手近なストックであるこれらの語尾が真っ先に出てきてしまうのです。だからこそ、最初の日本語テキストをリリースする前から役割語のチェック項目を設けていました。語尾に「〜わ」を連発するアシスタントでは、まるで吹き替えアニメのキャラクターが翻訳メモリの使い方を解説しているように聞こえてしまいます。
現在の彼女の日本語トーンは、温かみのある丁寧な「です・ます」調をベースに、ジェンダーニュートラルな「ね」や「よ」を控えめに添え、一人称は「わたし」(基本は省略)、ユーザーの呼び方は決して「あなた」とは呼ばず「〇〇さん」としています。役割語という衣装を脱がせながら彼女らしさを残せるかどうかは、主にスタイルガイドと、その違いを聞き分けられるレビュアーにかかっています。
カタカナの人名には綴りがない
日本語版のページでは、インタラクティブデモの構成を逆にしました。日本の書き手は日本語から翻訳したいと考えるため、アプリ全体を日本語で表示し、日本語の小説を英語に翻訳する様子をデモで見せるようにしたのです。そのためにオリジナルの短編小説『ひとり部屋のはずだった』(It Was Supposed to Be a Single)を書き下ろしました。念願のひとり部屋を手に入れた女子学生。だが午後11時47分、ドアの鍵が回る音がして……というストーリーです。
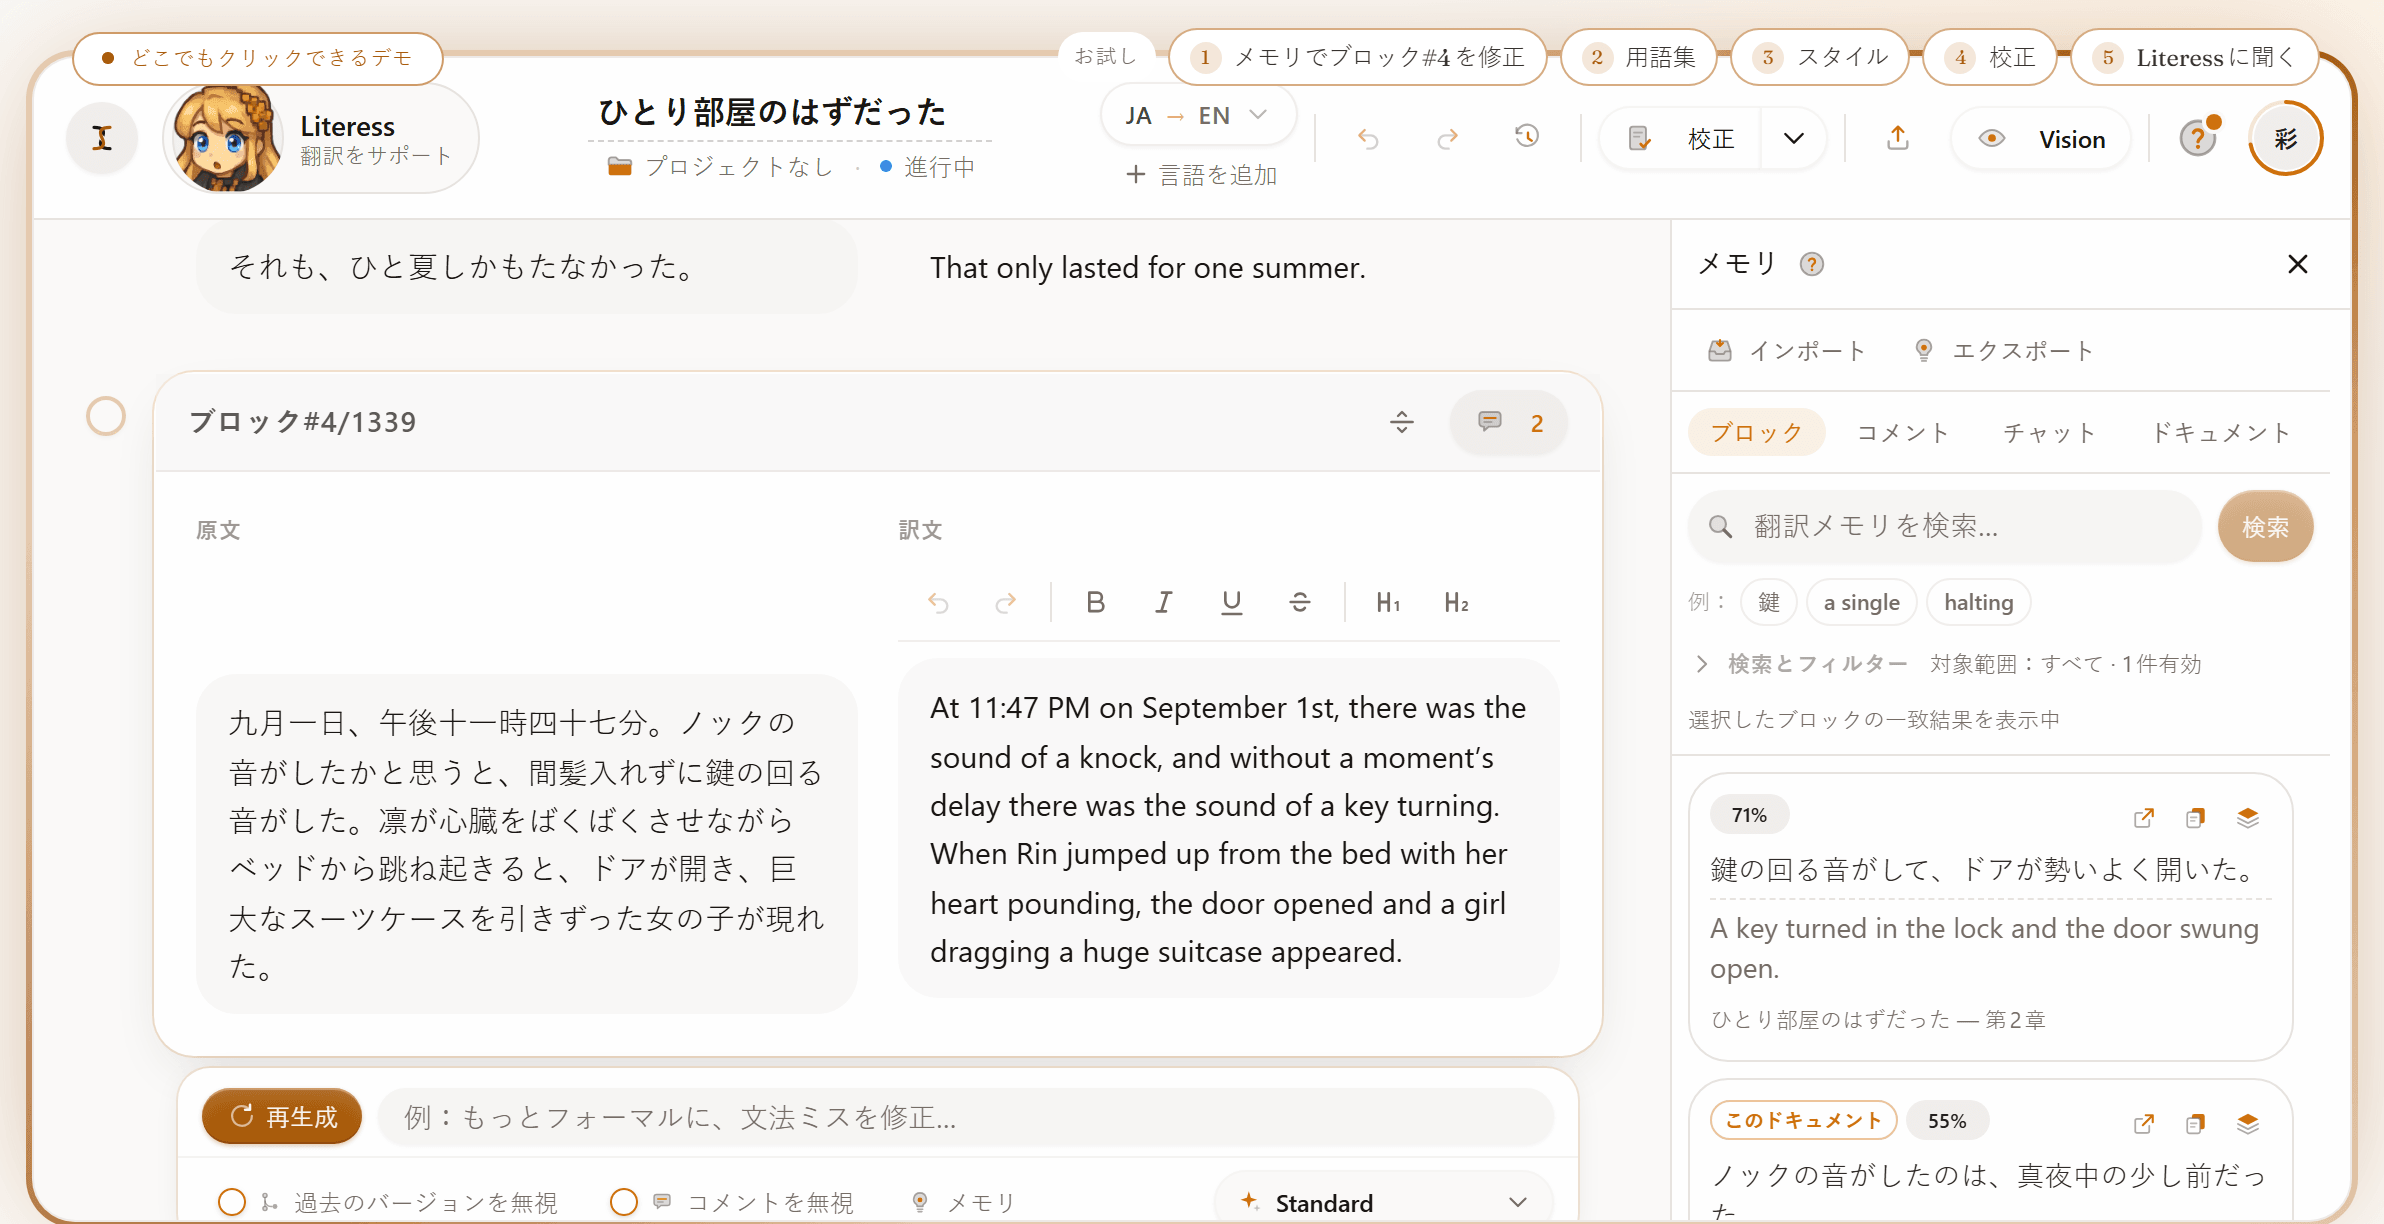
日本語ページのデモ画面。ブロック#4の英語はあえてぎこちなくしてあり、翻訳メモリで直せる。
新しいルームメイトはミラノからの留学生「ソフィア」。この名前は、用語集の役割を説明するのにこれ以上ない格好の例です。カタカナは音を表すものであり、アルファベットの綴り(スペル)は示しません。そのため「ソフィア」はSofiaともSophiaとも書け、日本語の原文からはどちらなのか判断がつかないのです。この人物がイタリア人だと知っている翻訳者ならSofiaと綴ります。しかし推測に頼るAIモデルはどちらか一方を選び、第12章ではもう一方を選んでしまうかもしれません。だからこそ用語集で固定します。「ソフィア → Sofia」と定義し、Sophiaを禁止用語に指定するのです。外国人のキャラクターが登場する翻訳マンガには、例外なくこの問題がつきまといます。それも大抵は何十箇所と。
この小説には、日英翻訳特有のぎこちなさもあえて残してあります。「鍵の回る音がした」を直訳すると「there was the sound of a key turning」になりますが、これは文法的には正しくても小説家なら決して書かない英語です。翻訳メモリには第2章で修正された表現(「a key turned in the lock」)が記録されており、ワンクリックでそれを適用できます。日本語版のホームページで、ぜひ実際に試してみてください。
またカタカナのせいで、UIのテキストが長くなるという現象も起きました。中国語を経験した後だったため、これは予想外でした。中国語で「Documents」は「文档」の2文字で済みます。一方、日本語では「ドキュメント」と6文字になり、「Documents」が余裕で収まっていたタブの中で2行に折り返されてしまったのです。日本語の改行処理はそれ自体が一つの大きなテーマです。Chromeの文節単位の改行処理では「ドキュメント全体」のような複合語をまとめて保持しようとするため、収まらない場合にはブラウザにヒントを与えます。日本語の読者が自然に区切るまさにその位置に、目に見えないゼロ幅スペースを忍ばせるのです。
ネイティブのレビューで見つかった「本当に危ない誤訳」
どの言語でも同様ですが、まずは機械がすべてを翻訳し、その後にネイティブレベルのレビューですべてを精読します。そして修正点はすべてTranseptに書き戻され、翻訳メモリに学習させます。日本語ではこのレビューによって約3,300件の修正が発生しました。内訳はウェブサイトで約2,150件、アプリ内で約900件、さらにヘルプセンター内のボタン表記をアプリと完全に一致させるための修正が251件です。
修正の大部分は文体の調整でした。しかし200件近くは意味が変わってしまっているものであり、まさにそれこそがこのレビュー工程を設けている理由です。日本語の機械翻訳は、厄介なことに「極めて礼儀正しく」間違えます。出力される文章は流暢で、申し分なくフォーマルで、自信に満ち溢れているのです。実際に起きたのは次のような事態でした。
- 英語では含みを持たせていた表現が、断定的な約束に変わっていた。
- 決済画面に、元の英語には影も形もない同意文言が出現していた。
- 返金条件が、実際のポリシーよりも厳格な内容になっていた。
- 一度も販売したことのない「€2,500のプラン」が出現していた。
一見したところ、おかしな点は何一つありませんでした。しかし、どれも約束として読まれてしまう内容ばかりです。信頼が関わる重要なページにおいて、日本語ほどレビューを通していない機械翻訳をそのまま世に出したくない言語はありません。
新しい言語は、UIの総点検になる
最後の教訓は、7月に学んだ教訓を別の角度から繰り返すことになります。ランディングページ用の日本語スクリーンショットを撮影したとき(実際のアプリを日本語UIにし、日本語から英語への翻訳を表示させた状態)、翻訳者の目には触れていなかった英語が画面のあちこちで見つかりました。次の通りです。
- コメントの投稿日時(「5m」「just now」)が英語のままハードコードされていた。
- テンプレートから開始したワークフローが英語名のまま引き継がれ、日本人ユーザーの画面に「小説・書籍」と並んで「Novel or book」が表示されていた。
- 共有ダイアログの文言が変数スロットを使って組み立てられており、そのスロットに生の英単語documentがそのまま代入されて「このdocumentへのアクセス権を管理」となっていた。
この最後の例はどの言語でも間違っていましたし、多くの言語ではそもそも正しく表示できるはずもありませんでした。ウクライナ語、ポーランド語、チェコ語ではその名詞に特定の格変化が必要ですが、生の英単語をそのまま突っ込んだスロットで対応できるわけがありません。スクリーンショットで目の当たりにするまで、誰にも気づかれずに放置されていたのです。現在では文全体をアイテムの種類ごとに3つの別々の文に分け、3つのバグすべてをすべての言語で修正してあります。
新しい言語を増やすたび、既存のすべての言語がより良いものになっていきます。これこそローカライズにおいてまったく予想していなかったことであり、次の言語の追加が楽しみでならない理由でもあります。
著者
Transept共同創業者。キーウ、オストラヴァ、そしてザルツブルクでの1年間を経て、英語学・英文学の学位を3つ取得。ウクライナ出身ですが、書くのはほとんど英語です。プロンプトエンジニアとしてAIの世界に入り、その後はプロダクトマーケティングとライフサイクルマーケティングを担当。実在の人物をもとにしたセミフィクションを書きながら、言語のあいだで何がこぼれ落ちるのかという問いを追い続けています。