メールのローカライズ:主要ESPでのキャンペーン翻訳ガイド
メールプラットフォームによって、言語の扱いはまったく異なります。自動で翻訳してくれるものもあれば、空のロケール枠を渡されるもの、手動で条件分岐を書かなければならないものもあります。Braze、Customer.io、Klaviyo、Mailchimp、Iterable、Brevoの実際の仕様と、Liquidコードを崩さずにテキストを翻訳する方法を解説します。
目次
私はライフサイクルマーケティングを担当しているため、これまで多くの時間をキャンペーンエディターの中で過ごしてきました。その中で、いつも甘く見てしまっていたのがメールのローカライズです。ランディングページの翻訳なら、決まった手順で進められます。一方、メールキャンペーンの翻訳は、扱うツールごとに作業がまったく異なります。そもそも「言語」をどう定義しているかが、プラットフォームごとに異なるからです。
テキストを自動で翻訳するプラットフォームもあれば、空のロケール枠を用意して入力を求めてくるものもあります。あるいは、メール本文内に分岐ロジックを手書きしなければならないものもあります。そして、そのすべてに共通する落とし穴が存在します。それは、本文にテンプレート構文が散りばめられており、1文字の狂いもなく翻訳から戻ってこなければ配信エラーになってしまうという点です。
本ガイドでは、主要プラットフォームの実際の仕様、テキストのエクスポートとインポートの手順、そしてどのツールでも共通して押さえておくべきポイントを解説します。
メールプラットフォームが言語を扱う3つの方式
プラットフォームごとの詳細を見る前に、3つのアーキテクチャのうちどれに当てはまるかを把握しておくとスムーズです。それによってワークフロー全体が決まり、たいていは後から変えられません。
| アーキテクチャ | プラットフォームが提供するもの | 自社で用意するもの | プラットフォーム |
|---|---|---|---|
| 自動翻訳に対応 | エディター内での機械翻訳、デフォルト言語から生成される言語別バリアント | レビュー、修正、翻訳除外リスト | Klaviyo、Customer.io、Brevo |
| ロケール枠のみを提供 | タグ付けされたコンテンツ、バリアントの枠組み、CSVやAPI経由のエクスポート/インポート | 訳文そのもの | Braze、Iterable |
| 機能提供なし | マージタグと条件分岐 | すべて(メール本文内に分岐ロジックとして記述) | Mailchimp |
本格的な多言語展開の多くはこの2番目のタイプに該当し、本ガイドでも主にこのパターンを取り上げます。「プラットフォームが用意するのは空のロケール枠だけ」という状況こそ、まさに翻訳ワークフローが不可欠になる瞬間だからです。
Brazeのメールローカライズ
Brazeはタグ付けして訳文を流し込むモデルを採用しており、その構文は他と比べても非常に特徴的です。メール内の翻訳対象となる各テキストを、ID付きのLiquidタグで囲みます。
{% translation greeting %}Hello!{% endtranslation %}基本的な記述形式は{% translation your_id_here %}default text{% endtranslation %}で、IDはメッセージ内で一意にする必要があります。選択範囲をタグで囲むエディターのショートカット(macOSではCmd+Alt+L、WindowsではCtrl+Alt+L)も用意されています。Braze自体が自動翻訳することはありません。CSVのアップロードまたはTranslations API(執筆時点では早期アクセス)を通じて訳文を用意します。
本格的なキャンペーン運用を始めると、ドキュメントに記載されている制限が重要になってきます。
| 項目 | 上限値 |
|---|---|
| メッセージあたりの翻訳タグ数 | 200 |
| デフォルトテキストあたりの文字数 | 2,000 |
| ロケールあたりの訳文のサイズ | 409,600バイト(約409.6KB) |
| ワークスペースあたりのロケール数 | 200 |
翻訳タグのネストには対応していません。ロケールはユーザープロファイルから取得されます。参照先は[Settings]→[Localization Settings]で設定し、デフォルトの属性(languageおよびcountry)かカスタム属性のどちらかを使います。両方が当てはまる場合は、カスタム属性が優先されます。
作業を始める前に、Braze特有の注意点を2点把握しておきましょう。
URLをタグで囲むとクリックトラッキングが機能しなくなります(囲んだ部分の末尾が?または&である場合を除く)。Brazeの公式ドキュメントには、回避策が直接記載されています:
<a href="https://{% translation id_1 %}example.com{% endtranslation %}?">Shop Now</a>翻訳CSVをExcelで開かないでください。Brazeの公式ドキュメントでも、英語以外の文字の表示崩れを防ぐため、Excelの使用を避けるよう明記されています。これは、Brazeのローカライズで誰も気づかないままデータが壊れる、最もよくあるパターンです。原因はBrazeではなくExcelにあります。ExcelはCSVの文字コードを推測し、その推測を誤るのです。
BrazeのContent Blocksには個別に訳文を持たせることができるため、共通フッターなどをキャンペーンごとに翻訳する手間を省き、1回でローカライズを完了できます。参照時は{{content_blocks.${your_block}}}のように記述します。Liquidタグ経由で挿入したブロックはリンクが維持されて自動的に更新されますが、エディターのドロップダウンから挿入したブロックは自動更新されません。特定のロケール向けの訳文がない場合、エラーにはならず原文の言語で表示されます。
タグ付けではなく分岐で処理したい場合、Brazeでは独自にロジックを組む方法にも対応しています。
{% if ${language} == 'en' %}
English content
{% elsif ${language} == 'es' %}
Spanish content
{% else %}
Fallback content
{% endif %}Liquidタグ内では属性をそのまま${language}と記述しますが、本文中では{{${language}}}のように二重の波括弧で囲む点に注意してください。言語が未設定のユーザー、未対応言語のユーザー、言語を検出できないデバイスのユーザーも存在するため、Brazeは常に{% else %}分岐を含めることを推奨しています。
ドキュメント:Brazeのローカライズ
Customer.ioのメールローカライズ
Customer.ioのアプローチは対照的です。ローカライズ機能が標準で組み込まれており、メッセージエディター内で完結するほか、AI自動翻訳ボタンも用意されています。デフォルト言語でメッセージを作成したうえで、キャンペーンを分岐させることなく言語バリアントを追加できます。メール、SMS、WhatsApp、プッシュ通知、アプリ内メッセージで共通して利用できます。
言語属性の命名は自由です。[Workspace Settings]→[Language settings]で、どのプロファイル属性に言語情報を持たせるかをCustomer.io側で指定できるため、languageやlocale、あるいはCRMですでに使われている任意の属性名をそのまま使えます。値は2文字のコード(en)か、ハイフンで区切られた言語・地域コード(en-US)である必要があります。大文字・小文字は区別されないため、es-MXでもes-mxでも動作しますが、ハイフンは必須です。
自動翻訳の対象となるのは本文、件名、プリヘッダーテキストです。一方、対象外となる項目は以下のとおりで、必ず把握しておく必要があります:
- 画像(ただし代替テキストは翻訳されます)
- リッチテキストエディターおよびコードエディター内のメールレイアウト
- Liquid内の静的テキスト、属性値、フィルター値
- スニペット
- カスタムコンポーネントのテキスト(事前にコンポーネントのリンクを解除している場合を除く)
3点目については、特に見落としやすいため具体例を挙げて説明します。Customer.ioの公式ローカライズドキュメントには、次のコード例が掲載されています。
Bonjour {{ customer.first_name | default:"ami" }}amiという単語は、名が登録されていない受信者全員に表示されるフォールバックです。これは読者の目に直接触れる実際の文面ですが、自動翻訳の対象外となるLiquidフィルターの内側にあります。このままドイツ語圏に配信すると、一部の受信者への挨拶がamiになってしまいます。すべてのdefault:フィルターに含まれるフォールバック文字列は、バリアントごとに手動で翻訳する必要があり、管理画面上に通知やリマインダーは表示されません。
設計時に考慮すべき制限事項がさらに2点あります。デフォルトテンプレートを変更しても翻訳は自動更新されない点、そして翻訳を含むA/Bテストは単発配信(One-time Send)では機能するものの、APIトリガー配信やオートメーションでは機能しない点です。
スニペットについても個別の注意が必要です。スニペットはコンテンツを再利用するための仕組み({{snippets.your_snippet}}、デフォルトで1件あたり16KB)ですが、自動翻訳ではスキップされます。Customer.ioでは、スニペットの内部に条件分岐を記述することが推奨されています。
{% if customer.language == 'fr' %}
  Se désabonner
{% elsif customer.language == 'de' %}
  Abmelden
{% else %}
  Unsubscribe
{% endif %}
そのため、Customer.ioでの運用は通常、メッセージ本文には標準の言語バリアントを使用し、共有スニペットの内部には手動で保守する条件分岐を記述する構成に落ち着きます。AIボタンですべてを完結できると思い込む前に、把握しておくべきポイントです。
ドキュメント:Customer.ioのローカライズ
Klaviyoのメールローカライズ
Klaviyoの機能はSmart Translationsと呼ばれ、キャンペーンエディターやフローエディター内からメッセージコンテンツを60以上の言語へ機械翻訳できます。Settings → Account → Translationにある[Translate messages]のトグルをオンにすると有効になります。有料アカウントが必要で、無料トライアルでは利用できません。
Klaviyoの公式ドキュメントで自動翻訳の対象として明記されているのは、テキストブロック、ラベル、代替テキストです。件名はこの一覧に含まれていないため、キャンペーン全体が網羅されていると思い込まず、事前にアカウント内で確認してください。
言語の判定には、デフォルトでプロファイルのLocaleが使用され、設定されていない場合はCountryまたはLanguageにフォールバックされます。KlaviyoはBCP-47コード(en-GB、es-ES)のほか、EnglishやFrenchといったプレーンテキストの値も受け付けます。
Klaviyoには作業をスムーズにする大きな利点が2つあります。1つ目はDo Not Translate list(翻訳除外リスト)です。ブランド名、製品名、モデルに翻訳させたくない用語などをアカウント単位で一度指定するだけで適用されます。多くのプラットフォームには同等の機能がなく、製品名が10のロケールでそのまま維持されるか、10通りの異なる単語に変わってしまうかの分かれ目となります。
2つ目は要素ごとのオーバーライドメニューです。翻訳された任意の要素で、Re-translate、Match source、Edit、Ignoreを選択でき、エディター上部の矢印で言語間を切り替えられます。これにより、全文を読み直す代わりに、フラグを付けた項目だけをチェックしてレビューを進められます。
KlaviyoはCSVのラウンドトリップ(往復エクスポート・インポート)にも対応しており、人間の翻訳者や外部ツールを利用する場合に適しています。Translate → 操作メニュー内にExport CSVがあり、SmartlingまたはSimple形式から選択できます。列構成はblock_id(翻訳可能な各文字列の一意の識別子)、source(原文のテキスト)、そして言語コードを列名にした言語ごとの列です。ルールは厳格ですが理にかなっています。block_idの値を編集・削除しない、行を追加しない、sourceの値を変更しない、の3つです。
BrazeやCustomer.ioに慣れた方が驚く点として、KlaviyoはLiquidを採用していません。Djangoテンプレート構文を使用しています。
{% if person|lookup:'Loyalty Points' > 150 %}
Hey VIP! You've always got free shipping & free returns
{% elif person|lookup:'Loyalty Points' > 0 %}
You have {{ person|lookup:'Loyalty Points' }} points, and you just need 150 to become a VIP!
{% else %}
Have you heard about our VIP program? Join today on our website to start earning rewards.
{% endif %}タグの見た目はLiquidにそっくりですが、elifとelsifの違いで午後をまるまる潰すことになりかねません。フォールバック付きのパーソナライズは、{{ first_name|default:'friend' }}のように記述します。
ドキュメント:Klaviyo Smart Translations · Django構文
Mailchimpのメールローカライズ
Mailchimpには標準の多言語キャンペーン機能がありません。あるのは条件分岐マージタグで、公式ドキュメントでは、1通のメール内にすべての言語を記述し、条件分岐で出し分ける方法が案内されています。
*|IF:MC_LANGUAGE=es|*
Spanish content here.
*|ELSEIF:MC_LANGUAGE=de|*
German content here.
*|ELSE:|*
Display English content for everyone else.
*|END:IF|**|MC_LANGUAGE|*には連絡先の言語コードが、*|MC_LANGUAGE_LABEL|*には読みやすい形の言語名が格納されます。Mailchimpは購読者のブラウザーから言語を自動検出しようとしますが、プロファイル → Settings → Languageから連絡先ごとに設定したり、インポート時に一括設定したりすることもできます。なお、*|END:IF|*はIFブロックとIFNOTブロックの両方を閉じる点にご注意ください。
たいていは、この制限ひとつで方針が決まります。件名の言語が異なっていれば、本文を読んでもらう前に開封すらされません。そのため、Mailchimpで3言語以上を扱うチームの多くは、結局言語ごとにキャンペーンを分けることになり、そうなると条件分岐マージタグを使ったアプローチは何のメリットももたらしません。テンプレートを作り終えてからではなく、計画段階で知っておくべきポイントです。
ドキュメント:Mailchimpのコンテンツ翻訳
Iterableのメールローカライズ
Iterableには本格的なロケール機能が備わっており、公式ドキュメントにはその機能ができることとできないことが、清々しいほど率直に明記されています。
ロケール機能はコンテンツを翻訳しません。
提供されるのはバリアントの枠組みだけであり、訳文は自分で用意する必要があります。その代わり、すべてのバリアントで1つのtemplateIdが共有されるため、10個の個別テンプレートに指標が分散することなく一元管理できます。言語ごとに複製したキャンペーンのレポート作成に苦労した経験があるなら、これだけでも設定する価値があります。
フィールド名は必ずlocaleにする必要があります。Iterableの公式ドキュメントでも明記されているとおり、languagePreferenceなど他の名前にすると、ユーザーとバリアントを一致させることができません。ロケール名はISO-639とISO-3166の組み合わせ(fr-CA、fr-FR)に従い、3文字のコードにも対応しています。また、ロケールは一度作成すると名前を変更できないため、20個も作成してしまう前に命名規則を決めておきましょう。ロケールが未設定の場合はデフォルトのローカライズが適用され、一致するロケールがない場合は、送信をスキップするかデフォルトを送信するかをプロジェクトレベルの設定で制御します。
また、Iterableは自前で多言語化する方法をはっきりと勧めていません:
Iterableは柔軟なプラットフォームであり、HandlebarsやCatalogを使用して複数言語のコンテンツを作成することも可能ですが、これらはローカライズにおけるベストプラクティスではありません。
テンプレートエンジンにはHandlebarsが採用されており、フィールド名は大文字と小文字が区別されます。また、WYSIWYGエディターには注意すべき特有の挙動があり、条件分岐をHTMLコメントで囲まないとエディターによって構文が崩れてしまいます。
<!--{{#if activeUser}}-->
    <div>Hi active user!</div>
<!--{{else}}-->
    <div>Hi inactive user</div>
<!--{{/if}}-->翻訳の往復(ラウンドトリップ)を行う場合、GET /api/templates/email/getを使用すれば、翻訳者向けにテンプレートコンテンツを抽出できます。
ドキュメント:Iterableの複数言語対応
Brevoのメールローカライズ
Brevoは、プラットフォーム側で翻訳してくれるタイプに入り、この機能ではMailchimpの最も直接的な競合です。連絡先の言語コードや国コードに合わせて適応するキャンペーンを1つ作成し、Add languagesをクリックすると、言語ごとにキャンペーンが複製され、手動またはBrevoのAIアシスタント「Aura」を使って翻訳できます。
言語ごとに変更できる項目は他社よりも幅広く、差出人名、件名、プレビューテキスト、メールのデザイン自体に加え、返信先アドレス、Google Analyticsのトラッキング、カスタム配信停止ページまで対応しています。特に件名の出し分けは、Mailchimpでは不可能な機能であるため、大きな利点といえます。
公式ドキュメントに記載されている制限事項として、ファイルベースの翻訳には非対応(CSVのラウンドトリップができないため、外部の翻訳会社を利用する場合は選択肢から外れます)、A/Bテストキャンペーンでは利用できない、保存済みセクションは言語ごとに用意する必要がある、といった点が挙げられます。設定したどの言語にも一致しない連絡先には、デフォルトバージョンが送信されます。
ドキュメント:Brevoの複数言語キャンペーン
Liquid、Handlebars、マージタグ:絶対に保護すべき構文
どのプラットフォームを使用していても、実際の翻訳工程には絶対に外せない要件が1つあります。本文にはテンプレート構文が含まれており、そのすべての文字が入力時と完全に一致した状態で戻ってこなければなりません。{% endif %}が翻訳されてしまえば、配信エラーにつながります。
本ガイドで取り上げた各プラットフォームの構文は以下のとおりです:
| プラットフォーム | テンプレート言語 | パーソナライズ | 条件分岐 |
|---|---|---|---|
| Braze | Liquid | {{${first_name}}} | {% if %} / {% elsif %} / {% else %} / {% endif %} |
| Customer.io | Liquid | {{customer.first_name}} | {% if %} / {% elsif %} / {% else %} / {% endif %} |
| Klaviyo | Django | {{ first_name }} | {% if %} / {% elif %} / {% else %} / {% endif %} |
| Mailchimp | マージタグ | *|FNAME|* | *|IF:X|* / *|ELSEIF:X|* / *|ELSE:|* / *|END:IF|* |
| Iterable | Handlebars | {{firstName}} | {{#if}} / {{else}} / {{/if}} |
| Brevo | Brevo Template Language | {{ contact.FIRSTNAME }} | {% if %} / {% else %} / {% endif %} |
ここで起きるトラブルのほぼすべては、3つのパターンに集約されます。
モデルがトークンまで翻訳してしまうケース:{{ prénom }}や{% si %}のように変換されてしまい、配信に失敗するか、コードがそのまま表示されてしまいます。実用的なツールであれば、テキストがモデルに渡る前にトークンをマスクし、処理後に復元するため、モデルがトークンを単語として認識することはありません。
モデルがトークンの位置を変えてしまうケース:言語によって語順が変わるため、トークンの位置が移動すること自体は自然です。問題は、別の節に紛れ込んでしまったり、{% if %}と{% endif %}の順序が逆になったりすることです。トークンの位置には意味があります。出力されたトークンの構成が入力時と一致しているか検証し、崩れている場合はブロックを再実行するのが確実な対処法です。
トークンの数が変わってしまうケース:特に危険なのは、トークンが脱落するケースです。名前や条件分岐が抜け落ちた状態でもメール自体は表示されてしまうためです。目視の確認よりも、機械的なカウントが重視されるのはこのためです。
そして、これら3つのパターンすべてをカバーする鉄則があります。それは、「条件分岐は別々の文字列として扱う」ということです。次の例には2つの独立した文面が含まれており、翻訳者やモデルに全体をひとかたまりとして渡してしまうと、文脈を添えて個別に渡す場合と比べて、どちらの訳文の質も落ちてしまいます。
{% if ${loyalty_tier} == 'gold' %}Gold members get an extra 10%.{% else %}Join Gold for an extra 10%.{% endif %}HTMLメールと文字列テーブルはまったく別の作業
この工程には、全体の設計を左右する大きな分かれ道が存在します。そして多くの場合、作業の途中で初めてその存在に気づくことになります。
メールコンテンツの一部はドキュメントです。HTMLテンプレートやレンダリング済みのメールなど、上から下へと流れる構造を持ったコンテンツがこれに該当します。これらは一続きの文章として翻訳するのが適切です。見出しとその下の本文はセットであり、両方を見渡せる翻訳者のほうが、どちらか一方しか見えない翻訳者よりも的確な判断を下せるからです。
一方で、それ以外のメールコンテンツは文字列テーブルです。各行が独立したキー付きリストであり、cta_button、subject_line、footer_unsubなどが該当します。これらには、文章そのもの以上に重要なメタデータが付随しています。決して変更してはならないキー、コンテキストコメント、そして多くの場合文字数制限です。件名が長すぎると、受信トレイで途中で切れてしまうためです。
BrazeのCSV、KlaviyoのCSV、そしてソフトウェア分野のあらゆるローカライズファイル形式(gettext PO、XLIFF)は文字列テーブルです。一方、HTMLテンプレートはドキュメントです。文字列テーブルをドキュメントとして扱うとキーが失われ、ドキュメントを文字列テーブルとして扱うと前後の文脈が分断されてしまいます。
Transeptで文字列ファイルのサポートを通常のドキュメントインポートに統合せず、独立した機能として構築したのはそのためです。メール文面のCSVをインポートすると、キー、原文、訳文が並ぶグリッド形式で読み込まれます。文字数制限はリアルタイムカウンターとして表示され、コンテキストコメントも各行に保持されます。
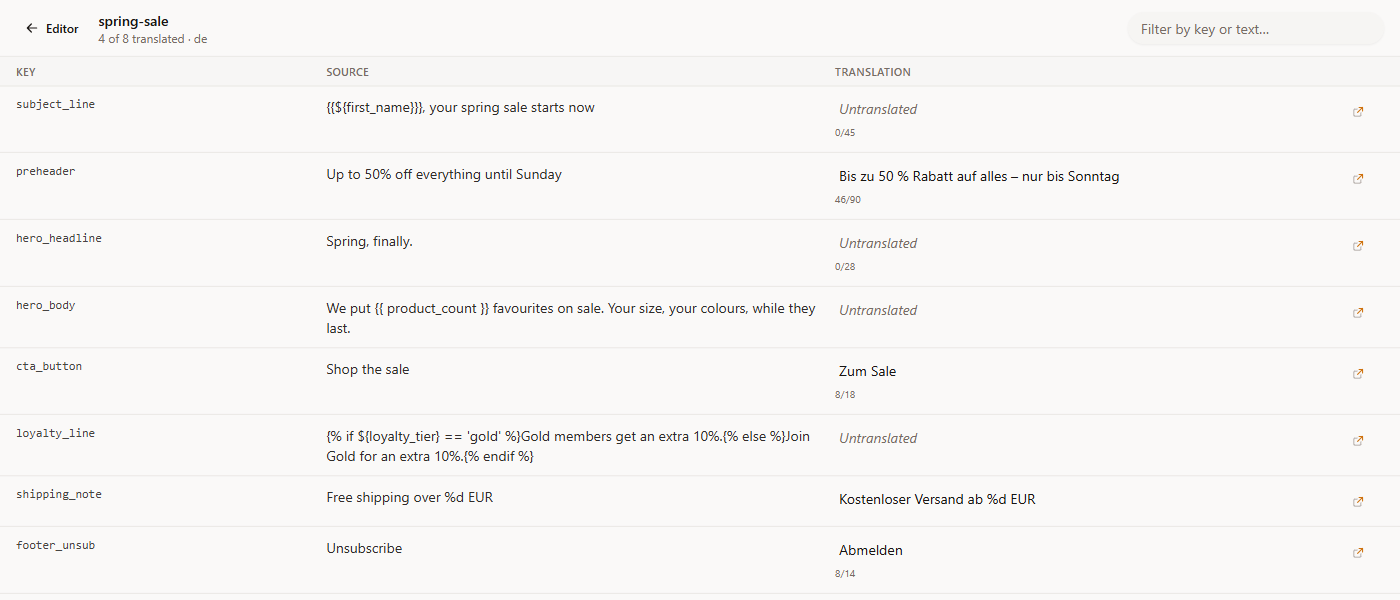
重要なのは、取り込んだ時と同じファイル構造のまま書き出されるという点です。後から手作業で構造を直す必要のあるファイルを出力するのではなく、プラットフォームが要求する通りの配置でキーや列を維持したまま、翻訳済みの元ファイルとしてエクスポートできます。
Transeptにメール対応機能を実装して分かったこと
まさにこのワークフローのために文字列ファイルのインポート機能をリリースしたのですが、その開発過程で、他では目にしたことのない数々の発見がありました。これらはすべて、実際のコードとテストの実行から得られた知見です。
「50% off」は、技術的にはprintfの変換指定子
ソフトウェアの文字列では、%s、%d、%1$sといったprintf形式のプレースホルダーがよく使われます。翻訳前にこれらをマスクする場合、一般的な正規表現を使うとprintfの仕様にあるすべてのフラグを許容することになります。これには、正の数の前にスペースを出力するスペースフラグ(% d)も含まれます。これはprintfの構文として正当であり、対応すること自体に合理的な理由があります。
しかし、マーケティングの文面においては致命的な問題を引き起こします。スペースフラグを許容すると、50% offの中に一致するパターンが見つかってしまいます。% oがスペースフラグ付きの8進数変換指定子として解釈されてしまうのです。同様に100% organicでも、販促メールで最も頻出する表現であるUp to 70% offでも同じ現象が発生します。
実際に両方のパターンでテストしてみました。
| 入力 | 厳密なパターン | スペースフラグあり |
|---|---|---|
50% off your first order | 一致なし | % o |
100% organic cotton | 一致なし | % o |
Hi %s, you saved %d%% | %s、%d、%% | %s、%d、%% |
% oをマスクすると、割引のフレーズがプレースホルダーに変わり、モデルには不自然に切り刻まれた文章が渡されてしまいます。そのためTranseptでは意図的にスペースフラグを除外していますが、何の問題もありません。実際の文字列テーブルでこのフラグが使われることなどないからです。
Brazeのパーソナライズタグには閉じ波括弧が3つある
これは、まさにこのガイドを書いている最中に見つけたものです。ガイドを書く意義を示す好例と言えます。
Brazeの構文は{{${first_name}}}です。末尾の波括弧を数えてみてください。属性自体の}に加えて、Liquidの出力タグを閉じる波括弧が2つあり、合計3つ連続しています。
ほぼすべてのLiquidトークナイザーは、最初に見つかった}}までを非貪欲にスキャンします。そのため{{${first_name}}}に対しては波括弧を1つ手前で閉じてしまい、{{${first_name}}までを認識して、単独の}が翻訳対象テキスト内に残ってしまいます。一見するとトークンが正しく処理されたように見えますが、取り残された波括弧は通常の文章としてモデルに送られ、位置がずれたり、重複したり、あるいは消えたりして返ってきます。
{{${first_name}}}, your spring sale starts now

  non-greedy scan  →  token: {{${first_name}}     leftover: "}, your spring sale starts now"
brace-aware scan → token: {{${first_name}}} leftover: ", your spring sale starts now"Transeptでは、取り残された波括弧が位置のずれた状態で戻ってきていました。発見後すぐにトークン内の1階層のネストを許容するように修正し、テストスイートにBraze独自の構文を追加しました。メール関連のツールを自前で保守している場合は、特に{{${attribute}}}のパターンでテストしてください。通常の{{ attribute }}形式は問題なく動作するため、バグが完全に隠れてしまうからです。
プレースホルダー内の引用符がJSONレスポンスを破損させる
文字列のバッチをモデルに送信し、レスポンスをJSONに制限する場合、返された文字列内にエスケープされていない"があると、文字列が途中で閉じられてバッチの残りが欠落してしまいます。Transeptでも引用符付きの属性を含むプレースホルダーでこの問題が発生し、あるモデルでは実行の約58%で再現しました。
解決策は、プロンプトでエスケープの指示を強化することではありません。通信形式から引用符を完全に排除し、エラー自体が発生しないようにすることです。モデルには引用符を含まないプレースホルダーのみを渡し、処理後に引用符付きの正規形式に復元します。「JSONを壊さないこと」とモデルに指示を出せば大抵の場合は機能しますが、これは信頼性としては最悪の部類に入ります。失敗に気づけないからです。
fuzzyエントリはシグナルであり、訳文ではない
gettextのPOファイルから文字列を取り込む場合、エントリには「これは自動一致によるものであり、人間による確認は完了していない」ことを示すfuzzyフラグが付いていることがあります。fuzzyエントリを完成した訳文として扱ってしまうと、大量の推測が承認済みの成果物としてインポートされることになります。
Transeptでは、これらを既存訳として取り込む対象(シーディング)から除外して新しく翻訳し、エクスポート時にfuzzyフラグを外します。その時点でエントリはレビュー済みで、フラグが示す内容はもう事実ではないからです。
メールキャンペーンのローカライズにおけるベストプラクティス
配信運用を円滑に進めるか、トラブル続きにするかを分ける重要な習慣を、効果の大きい順にご紹介します。
ロケールコードは、プロファイル単位で一度だけ決める。2文字コードか地域付きコードかを選び、どこでも同じ形式にそろえます。「訳文が表示されない」というトラブルの大半は、nl-BEのプロファイルにnlのメッセージを配信しようとしたことが原因です。
翻訳に出す前に、すべての文字列に文脈情報を添える。スプレッドシート上でShop the saleという文字列だけを見ても、翻訳者にはそれがボタンなのか見出しなのかリンクなのかも、18文字に収める必要があることもわかりません。文脈や説明の入力欄を用意しているプラットフォームはどれも、訳文の品質を最も高める情報を求めているのですが、記入する人はほとんどいません。
文字数制限を最優先の制約事項として扱う。ドイツ語は英語の約1.5~2倍の長さになります。英語では収まっていたCTAボタンの文字が枠からはみ出したり、件名が受信トレイ上で単語の途中で途切れたりします。翻訳者が文字数カウンターを確認しながら作業できるよう、文字列データに文字数制限を必ず持たせてください。
翻訳除外リスト(Do Not Translate list)を用意する。製品名、ブランド名、機能名などが対象です。Klaviyoにはこの機能が標準で備わっていますが、ほかのプラットフォームでは用語集で管理します。いずれにしても、製品名が6通りの訳語にブレてしまうのを見つけてからではなく、最初の実行前にリストを整えておくことが重要です。
フォールバックを翻訳する。すべてのdefault:フィルター、すべての{% else %}分岐、名が未登録のときに表示されるすべての「こんにちは」といった文面が該当します。これらはプレビュー画面に表示されないためレビューから漏れやすく、しかも情報が最も少ない受信者にそのまま届いてしまいます。
配信全体で過去の判断を再利用する。キャンペーンの文面は、共通のフッター、配信停止の案内文、毎年の季節のフレーズなど、同じ内容が繰り返し登場します。翻訳メモリを活用すれば、「Shop the sale」の訳文を一度確定させるだけで以降のすべてのキャンペーンで統一され、実行ごとに異なる判断が下されて3通りの表現にブレるといった事態を防げます。
本番配信の前に、すべての言語でテスト送信する。各ロケールの実際のプロファイルを使ってテンプレートを描画します。エディター上では正しく見えても、実際に描画して初めて発覚する条件分岐の不具合もあります。未翻訳のフォールバックや壊れた分岐を、まだ何のコストもかからないうちに見つけられるのが、このステップです。
よくある質問
メールのローカライズとは何ですか?
メールのローカライズとは、本文のコピー、件名、プリヘッダー、パーソナライズのフォールバック、配信先ロケールの表記規則など、メールキャンペーンを別の言語や市場向けに適応させるプロセスです。単なる翻訳とは異なり、メールにはそのまま維持しなければならないテンプレート構文(マージタグ、LiquidやHandlebarsの条件分岐など)が含まれ、件名の文字数制限などの制約にも対応する必要があります。
キャンペーンを自動翻訳できるメールプラットフォームはどれですか?
Klaviyo(Smart Translations、60以上の言語)、Customer.io(メール、SMS、WhatsApp、プッシュ通知、アプリ内メッセージでのAI自動翻訳)、Brevo(AIアシスタント「Aura」経由)は、エディター内で訳文を生成できます。BrazeとIterableはロケールの枠組みを用意するものの、訳文自体は別途用意する必要があります。Mailchimpには標準の多言語キャンペーン機能がなく、条件分岐マージタグに依存しています。
Mailchimpの件名は翻訳できますか?
いいえ。Mailchimpの公式ドキュメントには、件名フィールドでは条件分岐マージタグが機能しないため、件名は翻訳できないと明記されています。Mailchimpでローカライズした件名を配信するには、連絡先の言語フィールドでセグメントを分け、言語ごとに1つのキャンペーンを作成する必要があります。
Liquidタグが翻訳によって破損するのを防ぐには?
テキストが翻訳モデルに渡る前にトークンをマスクして単語として認識されないようにし、処理後に復元したうえで、結果を確定する前に出力されたトークン群が入力と一致しているか検証します。また、{% if %}...{% endif %}全体をひとかたまりとして渡すのではなく、条件分岐ごとに個別の文字列として翻訳することも品質向上につながります。各分岐がそれぞれ独立した文として翻訳されるためです。
HTMLメールと文字列テーブルの違いとは?
HTMLメールはドキュメントです。構造を持った一続きの文章であり、見出しと本文の間で文脈を保つために全体をまとめて翻訳するのが最適です。一方、文字列テーブルは各行が独立したキー付きリストであり、変更してはならないキー、通常はコンテキストコメント、そして多くの場合文字数制限が付随しています。BrazeやKlaviyoのCSVエクスポート、gettext POファイル、XLIFFはいずれも文字列テーブルです。この2つには異なる扱いが必要です。文字列テーブルをドキュメントとして扱うとキーが失われ、ドキュメントを文字列テーブルとして扱うと前後の文脈が分断されてしまいます。
翻訳にはCSVエクスポートとプラットフォームのAPIのどちらを使うべきですか?
人や外部ベンダーが翻訳する場合はCSVが現実的な選択肢で、BrazeとKlaviyoのドキュメントで説明されているのもこの方法です。一方、定期的に処理が発生する場合や、手作業でのファイル管理がボトルネックになるほどのボリュームがある場合は、APIによるラウンドトリップが適しています。Brazeは翻訳API(本稿執筆時点では早期アクセス)を提供しており、IterableはGET /api/templates/email/getを通じてテンプレートコンテンツを取得できます。Brevoはそのどちらにも対応しておらず、ファイルベースの翻訳機能がないため、管理画面上でキャンペーンを翻訳する必要があります。
1つのメールキャンペーンで何言語まで対応できますか?
プラットフォームによって異なります。Brazeはワークスペースあたり最大200のロケール、メッセージあたり最大200個の翻訳タグに対応しています。KlaviyoはSmart Translationsで60以上の言語をカバーしています。Customer.ioは数百種類の言語コードおよび言語・地域コードを受け入れます。実際には、プラットフォームの上限が制約になることはまれです。制約になるのは、原文の文面が変わるたびに、どれだけの言語をレビュー済みの最新の状態に保てるかです。
著者
Transept共同創業者。キーウ、オストラヴァ、そしてザルツブルクでの1年間を経て、英語学・英文学の学位を3つ取得。ウクライナ出身ですが、書くのはほとんど英語です。プロンプトエンジニアとしてAIの世界に入り、その後はプロダクトマーケティングとライフサイクルマーケティングを担当。実在の人物をもとにしたセミフィクションを書きながら、言語のあいだで何がこぼれ落ちるのかという問いを追い続けています。